Så kombinerar jag traditionell SEO med AI search
Jag bygger inte en SEO-strategi och en separat "GEO-strategi". För mig är det samma informationssystem med fler typer av sökresultat.
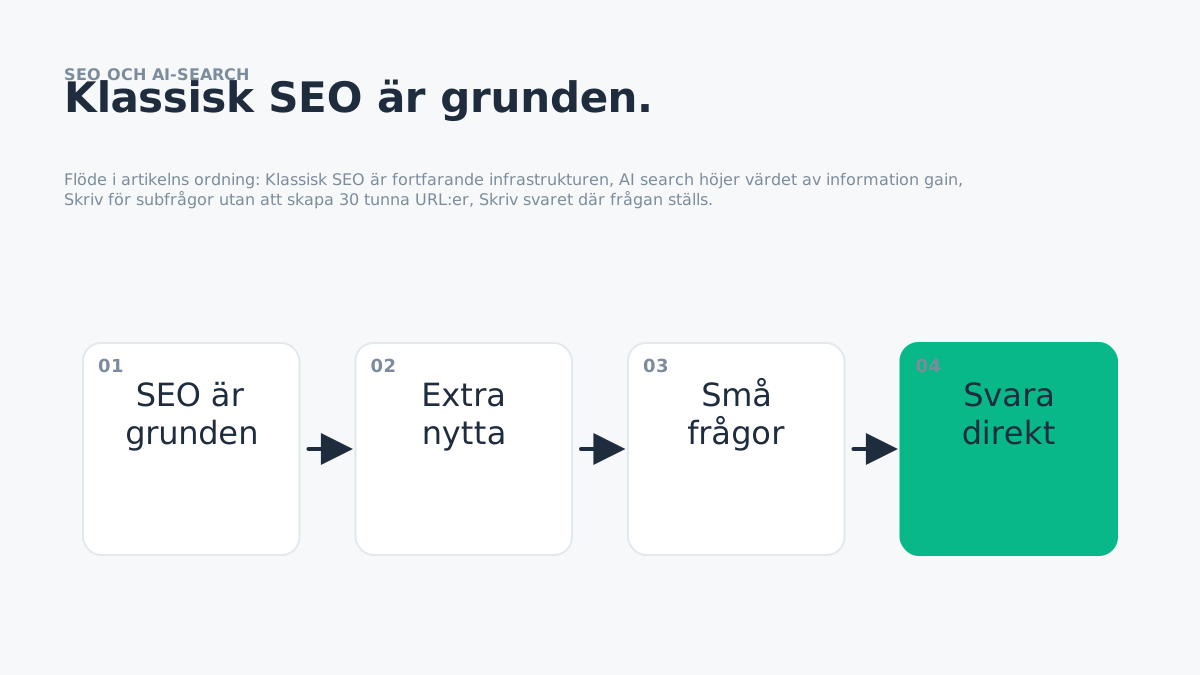
Jag bygger inte en SEO-strategi och en separat "GEO-strategi". För mig är det samma informationssystem med fler typer av sökresultat.
Google är också tydliga med att de grundläggande SEO-principerna fortsätter gälla för AI Overviews och AI Mode. En sida behöver fortfarande kunna crawlas, indexeras och vara relevant. Det finns inte ett hemligt schemafält som gör en svag sida till en bra AI-källa.
Klassisk SEO är fortfarande infrastrukturen
Jag börjar därför med samma saker som tidigare:
- rätt canonical URL,
- tydlig dominant intent,
- internlänkning,
- teknisk indexerbarhet,
- relevant title/H1,
- informationsarkitektur,
- innehåll som faktiskt löser uppgiften.
Om Google inte kan förstå och välja sidan i vanlig Search har jag inget stabilt fundament för AI-ytorna heller.
AI search höjer värdet av information gain
Det som förändras är hur lätt commodity content blir att ersätta. Om min artikel bara syntetiserar fem offentliga källor kan en generativ sökyta ofta göra samma syntes direkt.
Därför blir originalinformation viktigare: egen data, implementation, metod, erfarenhet, artefakter och tydliga beslut.
I BijoyIQ-briefarna har jag därför ett obligatoriskt fält för Unique Information Gain. En artikel om Skills ska exempelvis helst visa en verklig filstruktur eller research→Skill-kedja, inte bara definiera vad en Skill är.
Google beskriver samma riktning i sin aktuella AI-optimeringsguide: SEO fortsätter vara relevant, men innehåll som är valuable, unique och non-commodity är centralt.
Skriv för subfrågor utan att skapa 30 tunna URL:er
AI Mode och AI Overviews kan använda query fan-out över flera relaterade subfrågor. Det betyder inte att jag skapar en landningssida för varje möjlig formulering.
Jag vill i stället att en stark canonical behandlar sina nödvändiga delproblem tydligt. Om två subfrågor har olika intent och behöver helt olika svar kan de få separata URLs. Annars hör de ofta hemma som sektioner.
Det är exakt därför min första BijoyIQ-plan reducerades från 248 briefs till färre canonical URLs efter cannibalization-kontroll.
Skriv svaret där frågan ställs
Det gäller ner på H2-nivå också. En vanlig miss är att rubriken lovar ett svar men att själva definitionen kommer långt senare i stycket:
Jag håller den relationen tight för varje delfråga jag skriver H2 för — inte en 300-ords uppvärmning innan svaret kommer. Det gör innehållet bättre oavsett om en snippet eller ett AI-Overview-utdrag visar det, eftersom jag inte optimerar för en presentation jag inte kontrollerar. AI Overviews, AI Mode och vanliga SERP-features förändras; målet är en sida som fortfarande är bra om Google byter layout nästa månad.
Strukturera så att både människa och retrieval kan förstå
Bra rubriker, tydliga definitioner, tabeller där de hjälper och explicita relationer mellan begrepp gör en text lättare att använda. Jag gör det inte för att "mata AI". Jag gör det för att innehållet ska vara lätt att extrahera utan att betydelsen går förlorad.
Det viktiga är att strukturen inte blir mekanisk. Layer 8.1 i min egen contentfabrik fick exempelvis en corpus-gate efter att de första artiklarna blev överfragmenterade av för många underrubriker.
AI-genererad FAQ förtjänar sin plats, den får den inte automatiskt
Jag lägger inte FAQ längst ned på varje artikel som standard. Frågorna behöver representera konkreta följdfrågor som inte redan är bättre besvarade i brödtexten, och en modell genererar lätt redundans — tio frågor som bara formulerar om samma artikelrubrik. Jag kräver därför att varje fråga tillför en ny besluts- eller informationspunkt, och People Also Ask-frågor får bara vara researchinput jag mappar mot artikelns scope, inte ett facit jag kopierar rakt av. FAQ structured data har dessutom begränsad synlighet i Googles sökresultat, så schema är aldrig skälet att skriva sektionen. I våra första corpus-tester blev standard-FAQ ett återkommande AI-bloggmönster, så default hos mig är numera ingen FAQ — den måste förtjäna sin plats.
Mät AI-synlighet, men koppla den till affärsvärde
Search Console har under 2026 lagt till separata rapporter för generativ AI-synlighet. Det gör AI-features mindre av en svart låda. Men impressions i AI-ytor är fortfarande inte slutmålet.
Jag vill koppla synlighet till samma downstream-signaler som vanlig SEO: relevanta sessions, konverteringar, branded demand, leads eller faktisk användning.
Min SEO-stack blir därför inte ersatt
Den utökas:
Det är mindre dramatiskt än att deklarera att "SEO är dött". Men för mig är det en bättre arbetsmodell: retrievalsystemen förändras, medan kravet på att vara den mest användbara, begripliga och trovärdiga källan består.
Relaterade artiklar
- Så använder jag AI för Semantic SEO utan att massproducera skräp
- Min Research → SEO → Compliance → Brand → Writer-pipeline
- Hur jag byggde ett SEO-system istället för en SEO-prompt
- Hur jag avgör vad modellen ska läsa varje gång och vad som bara ska hämtas vid behov
- SEO-content agents: Researcher, Planner, Writer, Auditor