Så promptar jag AI för konsekventa varumärkesbilder
Det svåra med en AI-bild är sällan att få en snygg bild. Det svåra är att få bild nummer 17 att fortfarande kännas som samma varumärke.
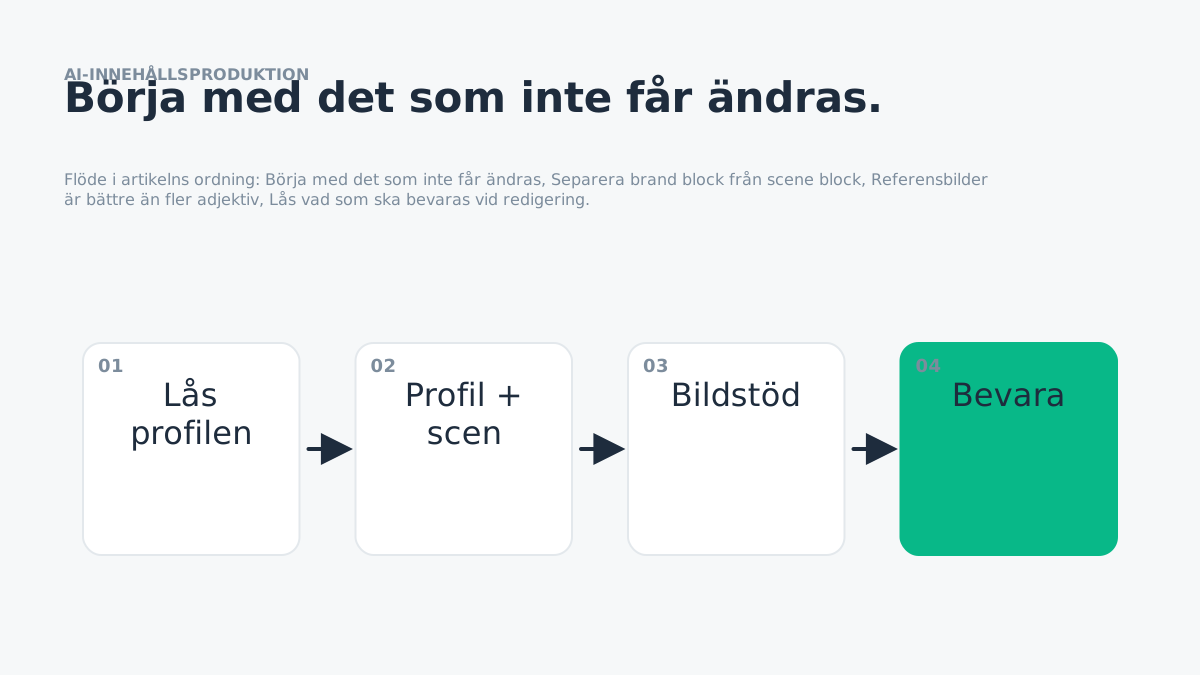
Det svåra med en AI-bild är sällan att få en snygg bild. Det svåra är att få bild nummer 17 att fortfarande kännas som samma varumärke.
Jag har därför slutat behandla varje bildprompt som ett kreativt engångsdokument. Jag bygger hellre ett litet visuellt system med fasta invariants och en separat del som får variera.
Börja med det som inte får ändras
För ett mat-/produktcase jag arbetat med ville jag återkommande ha en skandinavisk hemmakänsla: naturligt fönsterljus, trovärdig köksmiljö, vardaglig styling och en produktförpackning i bakgrunden som ska gå att känna igen utan att ta över motivet.
Det översätter jag till invariants:
Sedan får motivet variera: kvarg, energibollar, pannkakor, gröt eller vad serien kräver.
Separera brand block från scene block
Jag använder gärna två logiska delar i prompten. Brand block beskriver det konstanta: färgtemperatur, realism, material, typ av hem, hur mycket produkten får dominera och vad som är förbjudet. Scene block beskriver den aktuella bilden: vad som ligger i skålen, kameravinkel, händer i bild, placering av burken och format.
Det gör det enklare att iterera. Om alla bilder känns för stylade ändrar jag brand block. Om bara pannkaksbilden har fel komposition ändrar jag scene block.
Referensbilder är bättre än fler adjektiv
När en specifik förpackning, komposition eller känsla redan finns visuellt försöker jag använda referensbild i stället för att beskriva den med ytterligare 300 ord.
OpenAI:s bildguide rekommenderar, i skrivande stund, också att man tydligt beskriver hur flera referensbilder relaterar till varandra: exempelvis att en bild är layoutreferens och en annan stilreferens. Det minskar tvetydighet.
Lås vad som ska bevaras vid redigering
Vid image-to-image är min viktigaste formulering ofta inte vad som ska ändras utan vad som inte ska ändras.
OpenAI beskriver samma typ av targeted revision som ett bra sätt att minska drift mellan iterationer. Små förändringar en i taget fungerar bättre än att be om fem nya saker samtidigt.
Konsistens kräver ett eval-set även för bilder
Jag sparar gärna 5–10 godkända referensbilder som visuellt golden set. När en ny bild skapas granskar jag den mot samma dimensioner: ljus, realism, komposition, färgtemperatur, produktens relativa prominence, text/logo-integritet och graden av "AI-polish".
Det är inte pixelidentitet jag vill åt. Jag vill att variationen ska ligga inom varumärkets bandbredd.
Produkttext är en egen risk
Generativ bild-AI har just nu blivit bättre på text och logo preservation. OpenAI lyfter exempelvis förbättrad preservation av branded logos och key visuals i sina nyare bildmodeller. Jag behandlar ändå läsbar förpackning som ett explicit QA-steg, inte som något prompten garanterar.
Om fel text på produkten är oacceptabelt behöver den verifieras visuellt eller läggas på deterministiskt i efterbearbetning.
En bildprompt är ett designkontrakt
Det som gjort störst skillnad för mig är alltså inte "bättre promptord". Det är att prompten blir ett designkontrakt: här är invariants, här är variablerna, här är referenserna och här är det som måste QA-granskas efter generation.
Då går bildgenerering från experiment till ett reproducerbart contentworkflow.