Finansiell research: när Gemini, Claude och GPT är bra på olika saker
Jag har slutat fråga vilken modell som är bäst för finansiell research. Den frågan är för grov. Det som spelar roll är vilket jobb modellen ska göra, vilken data den får använda och hur dyrt ett fel är.
Jag har slutat fråga vilken modell som är bäst för finansiell research. Den frågan är för grov. Det som spelar roll är vilket jobb modellen ska göra, vilken data den får använda och hur dyrt ett fel är.
Finansiell research är flera jobb, inte ett benchmark
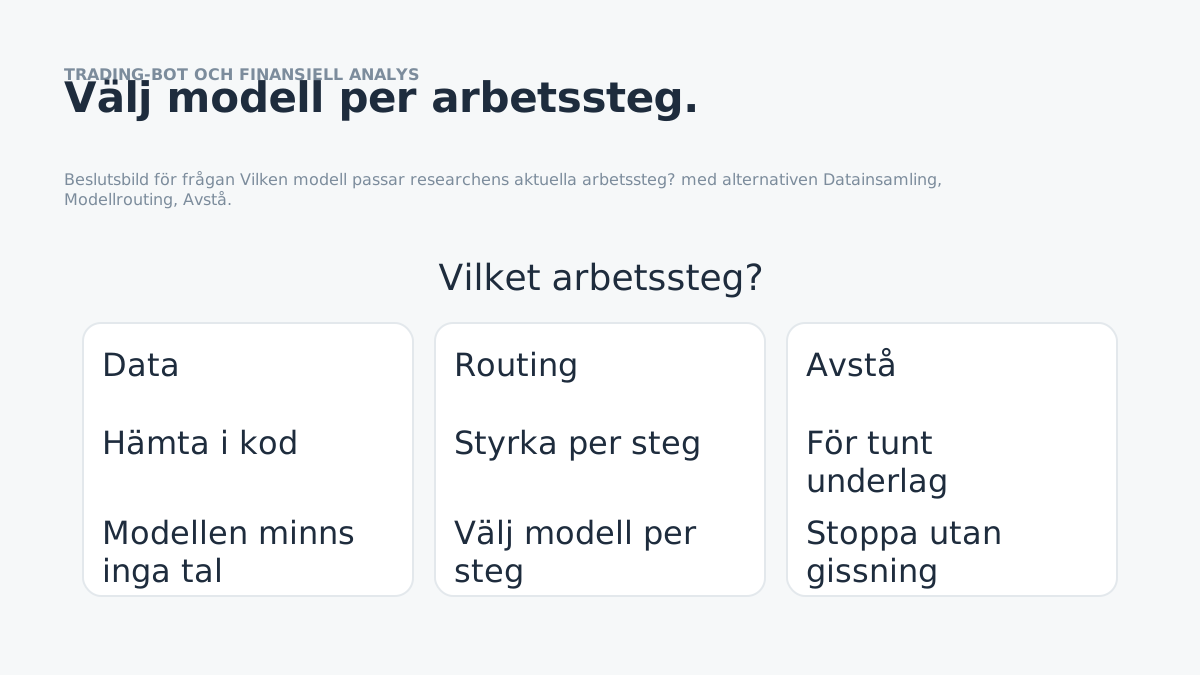
När jag använder språkmodeller i finansiell research försöker jag inte utse en universell vinnare mellan Gemini, Claude och GPT. Researchkedjan består av olika jobb: hitta och läsa källor, extrahera rapporterade fakta, normalisera siffror, resonera om ett case, skriva en investeringsanteckning och bevaka om en trigger inträffar. En modell kan vara bra i ett av stegen utan att vara bästa valet i nästa. Det gör modellvalet till ett routingproblem snarare än en topplista.
Deterministisk data först
Den viktigaste arkitekturregeln är att låta finansiella siffror komma från rätt datakälla, inte från modellens minne. Kurs, omsättning, marginal, skuld, antal aktier och rapportdatum ska hämtas eller beräknas deterministiskt när de används i en modell. LLM:n får resonera över datan, men den ska inte vara datakällan. Det är samma separation jag använder i andra system: kod äger exakta regler, modellen äger det som faktiskt kräver tolkning.
Jag routar efter arbetssteg
För dokumenttung research prioriterar jag lång kontext, bra källhantering och förmåga att arbeta metodiskt genom flera dokument. För analys prioriterar jag resonemang och förmåga att hålla isär rapporterade fakta från antaganden. För kortare syntes kan en billigare modell räcka. För varje steg testar jag därför samma verkliga uppgift på flera modeller och jämför fel, latency och kostnad i stället för att luta mig mot generella leaderboard-resultat.
Ett enkelt routingkontrakt
Mitt routingkontrakt innehåller normalt fyra fält: uppgiftstyp, riskklass, kontextstorlek och acceptabel felkostnad. Om uppgiften är låg risk och lätt att verifiera börjar jag billigare. Om den kräver komplex syntes eller om ett fel är dyrt eskalerar jag. Om outputen innehåller siffror kör jag dessutom strukturerad validering mot source-of-truth innan texten får lämna analyssteget.
Abstention är viktigare än modellnamnet
I finansiell AI är en av de viktigaste egenskaperna att systemet kan avstå. Om en rapport saknas, två källor motsäger varandra eller en värderingsmodell kräver data som inte finns ska slutläget kunna bli "kan inte bedöma". Det är mer värdefullt än att välja en modell som formulerar det mest övertygande svaret.
Så benchmarkar jag i praktiken
Jag sparar ett litet testset med verkliga uppgifter: extrahera nyckeltal från en rapport, förklara en marginalförändring, identifiera vilka antaganden som driver ett värderingsintervall och sammanfatta vad som skulle falsifiera caset. Sedan graderar jag factuality, källtrohet, missade reservationer och kostnad. Modellen som vinner ett sådant test får jobbet tills nästa modellversion eller större ändring motiverar en ny regression.
Slutsats
Poängen är därför inte att Gemini, Claude eller GPT "är bäst" för finans. Den hållbara arkitekturen är att finansdatan ligger utanför modellen, att varje arbetssteg har en tydlig eval och att modellen går att byta utan att investeringslogiken måste skrivas om.