GDPR och AI: En praktisk guide för företag
Många företag tvekar inför AI på grund av GDPR. Här är en praktisk guide till databehandling, samtycke och automatiserade beslut, utan juridiskt fikonspråk.
Många företag tvekar inför att rulla ut AI-lösningar för att de är oroliga för GDPR. Det är förstås helt rimligt. Böterna är stora och lagstiftningen kan kännas som en ogenomtränglig snårskog av byråkrati. Men sanningen är att du faktiskt inte behöver vara jurist för att navigera detta. Du behöver bara sunt förnuft, en tydlig process och en förståelse för de grundläggande principerna.
Låt oss bryta ner vad GDPR betyder när du bygger eller köper in AI-system. Vi ska titta på hur du kan använda AI för att skapa värde utan att riskera dina kunders integritet eller företagets rykte.
Vad tränar du egentligen modellen på?
Det absolut största misstaget företag gör idag är att de kastar in all sin tillgängliga kunddata i en AI-modell utan att tänka efter. De ser en guldgruva av information och vill bygga den smartaste assistenten på marknaden. Men om du använder personuppgifter för att träna en modell behandlar du data i lagens mening. För att behandla data behöver du en laglig grund.
Om du köper en färdig tjänst, till exempel en chattbot från en stor leverantör eller använder ett API från en molnleverantör, måste du veta exakt vad de gör med din data. Använder de dina kunders frågor, e-postmeddelanden eller köphistorik för att träna sina egna globala modeller? Om svaret är ja har du ett stort problem. Du måste säkerställa att avtalen uttryckligen förbjuder dem från att använda din data för sina egna syften.
Ett klassiskt exempel är när anställda klistrar in känslig kundinformation i publika AI-verktyg för att snabbt sammanfatta ett möte. Den datan kan sedan användas för att träna framtida versioner av verktyget. Det är ett solklart brott mot GDPR. Lösningen här är inte att förbjuda AI. Istället bör du ge de anställda tillgång till säkra och företagsanpassade verktyg där datan stannar inom era väggar.
Varför samtycke sällan fungerar för AI
Många tror att lösningen på alla GDPR-problem är att bara lägga till en extra rad i användarvillkoren: "Vi använder din data för att träna våra AI-modeller". Men GDPR kräver att ett samtycke är specifikt, informerat och frivilligt.
Om kunden måste tacka ja till AI-träning för att överhuvudtaget kunna använda din tjänst är det inte frivilligt. Om du inte kan förklara exakt hur modellen fungerar och vilka konsekvenser det kan få för individen är det inte informerat. Eftersom AI-modeller är notoriskt svåra att förklara faller samtycket ofta platt.
Istället för att förlita dig på samtycke bör du titta på "berättigat intresse" eller ännu hellre anonymisering. Kan du tvätta datan innan den rör vid AI-modellen? Om du plockar bort namn, e-postadresser, personnummer och andra identifierande detaljer innan datan används för träning minskar du risken dramatiskt. Det är ofta den mest praktiska och hållbara vägen framåt. Syntetisk data är ett annat användbart verktyg som fler företag borde utforska. Det är data som är artificiellt genererad men behåller de statistiska egenskaperna av riktig data.
Automatiserade beslut och rätten till en människa
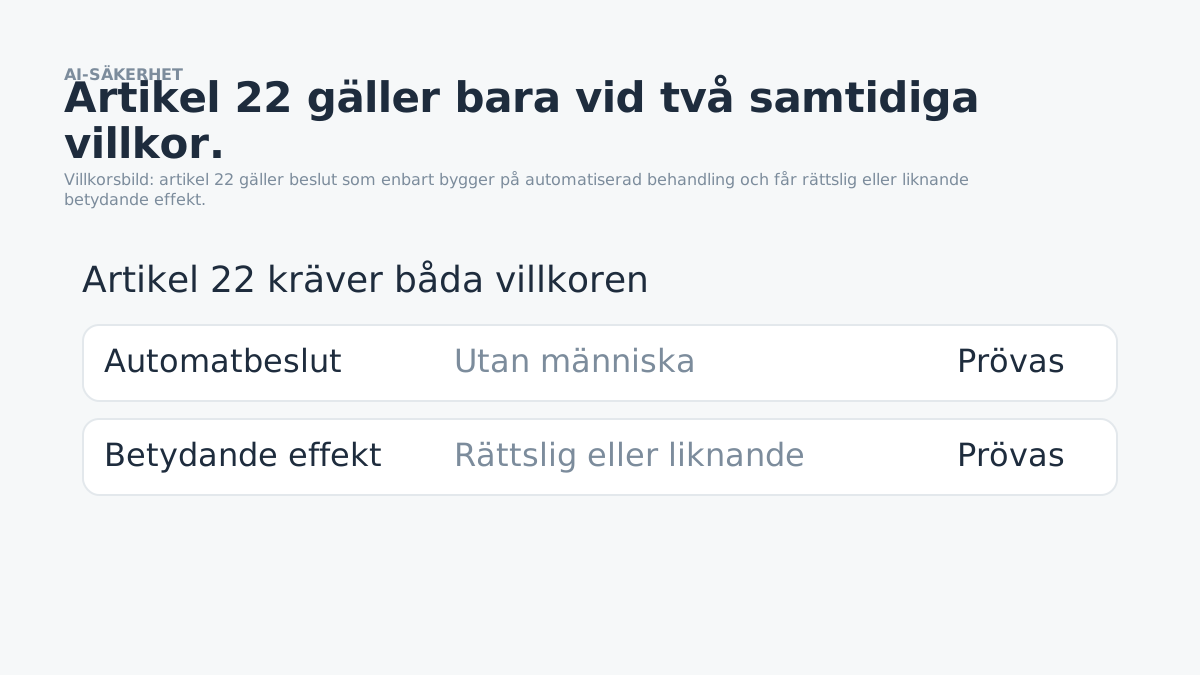
GDPR har en specifik regel som är extremt relevant för AI. Det handlar om Artikel 22. Den säger i princip att människor har rätt att inte bli föremål för beslut som enbart bygger på automatiserad behandling om beslutet har rättsliga följder eller påverkar dem på ett liknande betydande sätt.
Vad betyder det i praktiken? Låt oss säga att du bygger ett AI-system för att hantera låneansökningar, sortera jobbansökningar eller flagga misstänkta bedrägerier. Om din AI automatiskt nekar någon ett lån, kastar en kandidats CV i papperskorgen eller stänger av en användares konto måste det finnas en människa med i loopen.
Du kan absolut använda AI för att ta fram ett beslutsunderlag, analysera risker och ge rekommendationer. Men en människa måste trycka på den sista knappen och ta ansvar för beslutet. Om kunden ifrågasätter beslutet måste du kunna förklara hur ni kom fram till det. Att rycka på axlarna och säga "datorn sa nej" eller "algoritmen bestämde det" är inte en giltig ursäkt enligt lagen. Du måste kunna förklara logiken bakom beslutet.
DPIA: Mycket mer än bara en pappersprodukt
När du inför ett nytt AI-system som hanterar personuppgifter måste du göra en DPIA (Data Protection Impact Assessment, eller konsekvensbedömning avseende dataskydd). Det gäller särskilt om det innebär hög risk för individernas rättigheter.
Många företag ser detta som ett tråkigt formulär som ska fyllas i av compliance-avdelningen och sedan glömmas bort i en byrålåda. Det är helt fel inställning. En DPIA är ett utmärkt och praktiskt verktyg för att tvinga ditt utvecklingsteam och ledningsgrupp att tänka igenom riskerna innan ni bygger något.
Ställ de svåra frågorna tidigt. Vad händer om modellen läcker data? Vad händer om den börjar diskriminera vissa grupper av användare? Hur raderar vi en specifik persons data ur modellen om de begär att bli glömda?
Det sista är särskilt knepigt. Det är ofta tekniskt omöjligt att "glömma" specifik data i en redan tränad modell utan att träna om hela modellen från grunden. Det kostar enorma summor. Det är precis därför du inte ska träna på personuppgifter från början. Om du vill veta mer om hur du testar dina system och hittar dessa sårbarheter innan de går live kan du läsa vår guide om vad du måste testa före lansering.
Hur hänger detta ihop med AI Act?
GDPR är inte den enda lagstiftningen du behöver bry dig om framöver. EU:s nya AI-förordning (AI Act) är redan här och den bygger vidare på många av principerna i GDPR. Men där GDPR fokuserar på personuppgifter fokuserar AI Act mer på själva AI-systemets risker oavsett vilken data det hanterar.
Medan GDPR handlar om personlig integritet handlar AI Act om säkerhet, transparens och grundläggande rättigheter. De två lagarna överlappar varandra på många områden. Om du har dålig koll på GDPR idag kommer AI Act att bli en mardröm att implementera. Vi har skrivit en separat och djupgående genomgång om vad svenska företag behöver veta om EU AI Act.
Praktiska steg för att komma igång idag
Att sitta still i båten och vänta på att lagstiftningen ska bli tydligare är inte en strategi. Dina konkurrenter bygger redan. Här är fem konkreta steg du kan ta idag för att bygga AI-lösningar som respekterar GDPR:
- Kartlägg datan skoningslöst: Vet exakt vilken data som skickas till AI-modellen, både i träningsfasen och i produktion. Är det personuppgifter? Om ja, varför?
- Anonymisera vid källan: Tvätta datan innan den når modellen. Använd verktyg som automatiskt maskerar namn, adresser, telefonnummer och andra identifierande detaljer.
- Granska leverantörsavtalen: Om du använder externa API:er (som OpenAI, Anthropic eller Google), se till att du använder deras företagsversioner. Säkerställ att avtalet uttryckligen säger att de inte tränar på din data.
- Designa för mänsklig inblandning: Låt inte AI fatta kritiska beslut om människor helt på egen hand. Bygg in gränssnitt där människor granskar och godkänner AI:ns rekommendationer.
- Gör DPIA till en vana: Integrera konsekvensbedömningar i er vanliga utvecklingsprocess. Gör det till en del av designfasen, inte ett efterspel.
Att bygga AI-lösningar som respekterar GDPR är varken omöjligt eller ett hinder för innovation. Det kräver bara att du tänker efter före, bygger in integritet från början (privacy by design) och slutar försöka lappa ihop säkerheten i efterhand.
Vi älskar de här samtalen. På riktigt. Att sitta med ett företag och plötsligt se hur pusselbitarna faller på plats när rätt teknik möter rätt problem. Det är därför vi gör det här. Låt oss ta det samtalet.