Mitt arbetssätt för att iterera en prompt från 5/10 till 9/10
Jag har slutat optimera prompts genom att läsa två outputs och välja den som känns bäst. En bra promptiteration börjar med failure cases, baseline och en liten förändring som går att mäta.
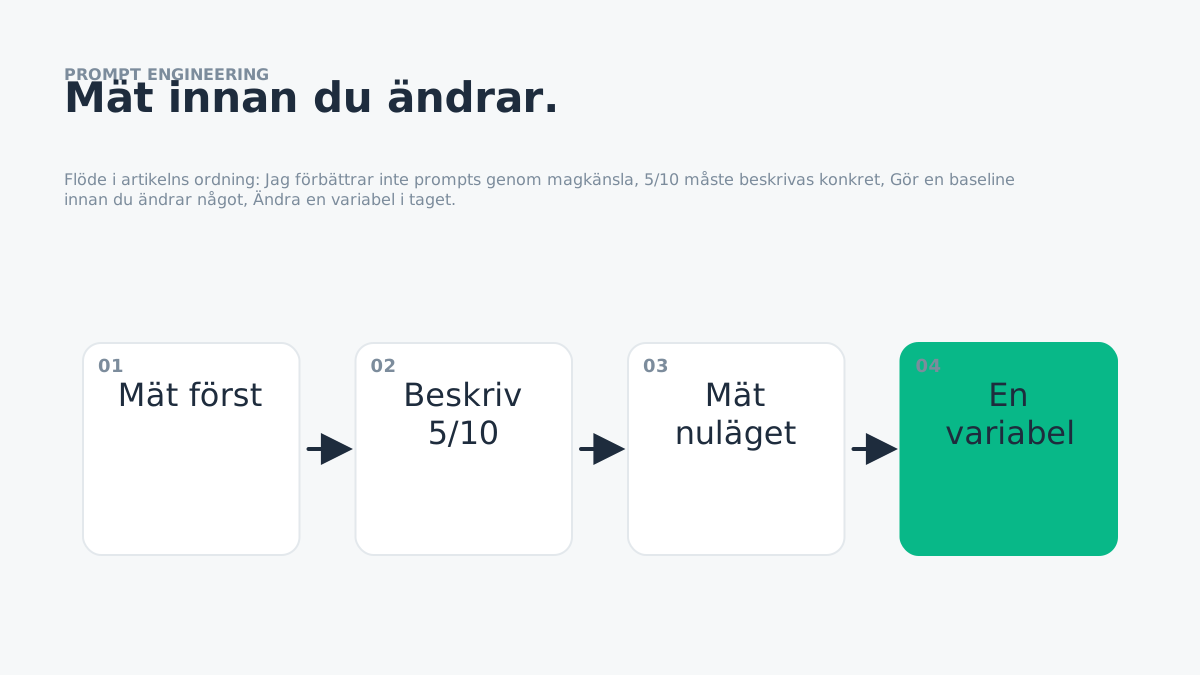
Jag har slutat optimera prompts genom att läsa två outputs och välja den som känns bäst. En bra promptiteration börjar med failure cases, baseline och en liten förändring som går att mäta.
Jag förbättrar inte prompts genom magkänsla
När en prompt går från "helt okej" till riktigt pålitlig sker det sällan genom att lägga till fler adjektiv. Jag samlar failure cases, gör en baseline och ändrar en sak i taget.
5/10 måste beskrivas konkret
Jag börjar med fem till tio exempel där prompten misslyckas: fel format, missad constraint, för mycket text, fel tool, påhittad data eller dålig prioritering. "5/10" blir då inte ett humör utan en lista med observerbara fel.
Gör en baseline innan du ändrar något
OpenAI:s prompt-tuning guidance, som är skriven för GPT-5 och kan bli inaktuell när modellversionen byts, rekommenderar uttryckligen att börja med evals och köra befintliga prompts som baseline. Det är viktigt eftersom annars varje ny version bedöms mot minnet av den gamla, inte mot samma testuppsättning.
Ändra en variabel i taget
Jag försöker inte samtidigt lägga till role, examples, XML, längre context och en ny output schema. Då vet jag inte vad som hjälpte. En iteration kan exempelvis bara lägga till två kontrasterande examples. Nästa kan ändra output contract. Det är långsammare per edit men snabbare till en stabil prompt.
Optimera mot failure modes, inte stilpreferenser
Om felet är att agenten missar edge cases behöver jag kanske ett review-steg, inte en starkare formulering av "var noggrann". Om den hittar på fält behöver jag schema validation. Prompt engineering ska inte användas för problem som deterministiska kontroller löser bättre.
Spara version, resultat och regressionsnot
Jag vill kunna säga v7 löste T03 och T08 men bröt T11. Då blir nästa steg uppenbart. Utan versionslogg tenderar prompten att växa som en sedimentär bergart där ingen längre vet varför varje mening finns.
9/10 betyder stabil på kända fall
Det betyder inte perfekt. Det betyder att prompten klarar den nuvarande eval-matrisen på en nivå som är bra nog för produktens riskklass. Nya produktionsfel blir nya tests. Det är så prompten fortsätter utvecklas utan att bli en religion.
Min praktiska tumregel
Baselina, ändra en sak, kör samma evals, logga regressionen. Upprepa.