Så bygger jag claim-level fact checking
Claim-level fact checking börjar med en enkel idé: bryt texten i verifierbara påståenden och kontrollera varje påstående mot evidens. I praktiken är det lätt att bygga en pipeline som ser rigorös ut men skapar falsk precision.
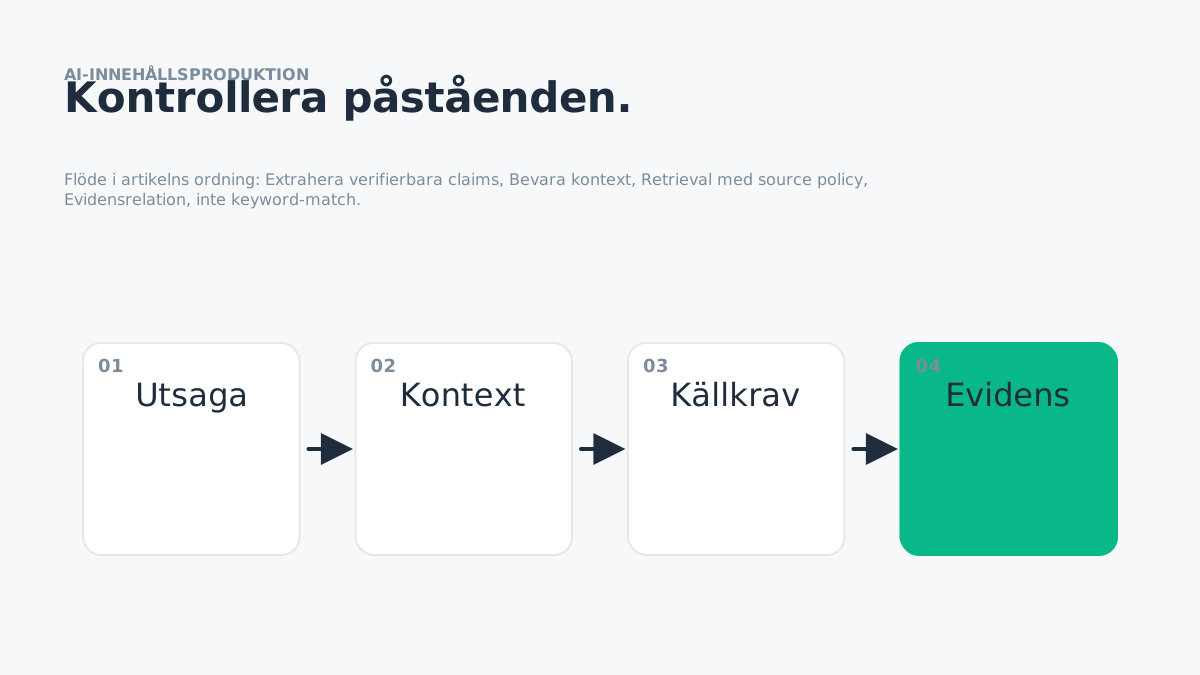
Claim-level fact checking börjar med en enkel idé: bryt texten i verifierbara påståenden och kontrollera varje påstående mot evidens. I praktiken är det lätt att bygga en pipeline som ser rigorös ut men skapar falsk precision. Om claim-extraktionen tappar kontext, retrieval hittar en närliggande men irrelevant källa eller verdict saknar kvalificering får du en snygg tabell som ändå inte säger om artikeln är korrekt. Jag designar därför varje steg med ett eget kontrakt och egna felmoder.
Steg 1: extrahera verifierbara claims
Jag skiljer faktiska claims från råd, värderingar och rent strukturell text. En claim ska vara tillräckligt atomär för att verifieras men inte så sönderhackad att betydelsen försvinner. Det gör kontrollen granskningsbar — jag vill kunna peka på vilken artefakt som bar beslutet och vad som skulle behöva ändras för att samma case ska få ett annat utfall.
Steg 2: bevara kontext
Pronomen, tidsperiod, jurisdiktion och definitioner behöver ibland följa med. Decontextualization betyder inte att all kontext ska bort; det betyder att claimen ska kunna förstås självständigt utan att ändra innebörden. Jag testar alltid minst ett fall där principen borde stoppa flödet — om modellen ändå producerar ett självsäkert resultat har jag byggt en rekommendation, inte en gate.
Steg 3: retrieval med source policy
Sökningen ska veta vilken typ av källa som krävs. Ett API-beteende bör normalt verifieras mot officiell dokumentation, medan ett forskningspåstående bör gå till originalpaper. I skala blir det här också ett datahanteringsproblem: när IDs, status och ägarskap är explicita går det att återöppna just de delar som påverkas av en ny källa eller en regression.
Steg 4: evidensrelation, inte keyword-match
Systemet behöver bedöma om källan faktiskt stödjer, motsäger eller inte avgör claimen. Textuell likhet räcker inte, särskilt när ett villkor eller undantag ändrar slutsatsen. Det är viktigt att scope följer med: en regel som fungerar i ett visst innehåll eller en viss riskklass ska inte automatiskt bli global standard för alla agentuppgifter.
Steg 5: verdict med qualification
Jag försöker hålla nästa steg enkelt: jag använder VERIFIED, QUALIFIED, UNRESOLVED, CONFLICT och REMOVED. Den modellen är mindre binär men mycket bättre för redaktionellt arbete, och handoffen ska innehålla evidens, beslut, osäkerhet och nästa ägare i stället för att nästa agent behöver tolka hela historiken.
Steg 6: täckning
En pipeline måste mäta vilka materiella claims som aldrig fick evidens. Annars kan den få hög precision på de claims den valde att kontrollera och samtidigt missa det viktigaste i texten. Det här är en av de punkter där bättre struktur ofta slår en dyrare modell — om systemet inte vet vad som ska mätas kommer mer reasoning bara ge ett mer övertygande oklart svar.
Steg 7: editorial patch med provenance
När en claim ändras ska det gå att se vilket source ID och vilket verdict som motiverade omskrivningen. Editorn får inte skapa ett nytt materiellt påstående som aldrig gick genom verifieringen. En bra regression här är medvetet tråkig: samma case ska kunna köras efter en promptändring, modelluppgradering eller refaktorering och visa exakt vilken dimension som flyttade sig.
Testa decomposition-fel explicit
Forskningen — i preprints som ännu inte är kollegialt granskade — visar att decomposition inte alltid förbättrar slutresultatet. Jag sparar därför cases där uppdelning skapar brus, tappar relationer eller gör retrieval svårare, och behandlar misslyckanden som framtida testdata. Ett dyrt fel som bara dokumenteras i en post-mortem är en missad möjlighet; nästa release bör möta samma situation i evalsviten.
Ett kontrakt som går att testa
Kontraktets fält — case_id, input, evidence, expected_behavior, grader och result — och varför jag skiljer själva uppgiften från den tillfälliga modell som kör den beskriver jag i artikeln om hur jag tänker kring evals före lansering.
Slutsats
Claim-level faktakontroll är stark när varje steg kan underkännas separat. Extraktion, retrieval och verdict behöver egna kvalitetsmått, annars riskerar en sofistikerad pipeline att bara automatisera osäkerhet.
Källor och vidare läsning
- Claim Extraction for Fact-Checking
- Towards Effective Extraction and Evaluation of Factual Claims
- Decomposition Dilemmas