Så designar jag AI-produkter för användare som inte bryr sig om AI
De flesta användare vill inte ha en relation med modellen. De vill få något gjort. Det låter självklart, men många AI-produkter börjar ändå med ett stort tomt chattfält och lägger ansvaret på användaren: formulera problemet, ge rätt kontext, välj ton, förstå begränsningarna och bedöm sedan om sva...
De flesta användare vill inte ha en relation med modellen. De vill få något gjort. Det låter självklart, men många AI-produkter börjar ändå med ett stort tomt chattfält och lägger ansvaret på användaren: formulera problemet, ge rätt kontext, välj ton, förstå begränsningarna och bedöm sedan om svaret blev bra.
När jag bygger egna tjänster försöker jag göra motsatsen. AI:n får gärna vara avancerad under huven, men gränssnittet ska i första hand beskriva jobbet. I CVpiloten betyder det att användaren inte ska behöva kunna prompta för att förbättra ett CV. I ett utbildningsverktyg ska användaren inte behöva förstå en agentarkitektur för att få nästa relevanta övning. Och i en contentpipeline ska redaktören inte behöva hålla nio agentroller i huvudet för att veta om en artikel är redo.
Det här har blivit en av mina viktigaste produktprinciper: AI-native behöver inte betyda AI-synligt.
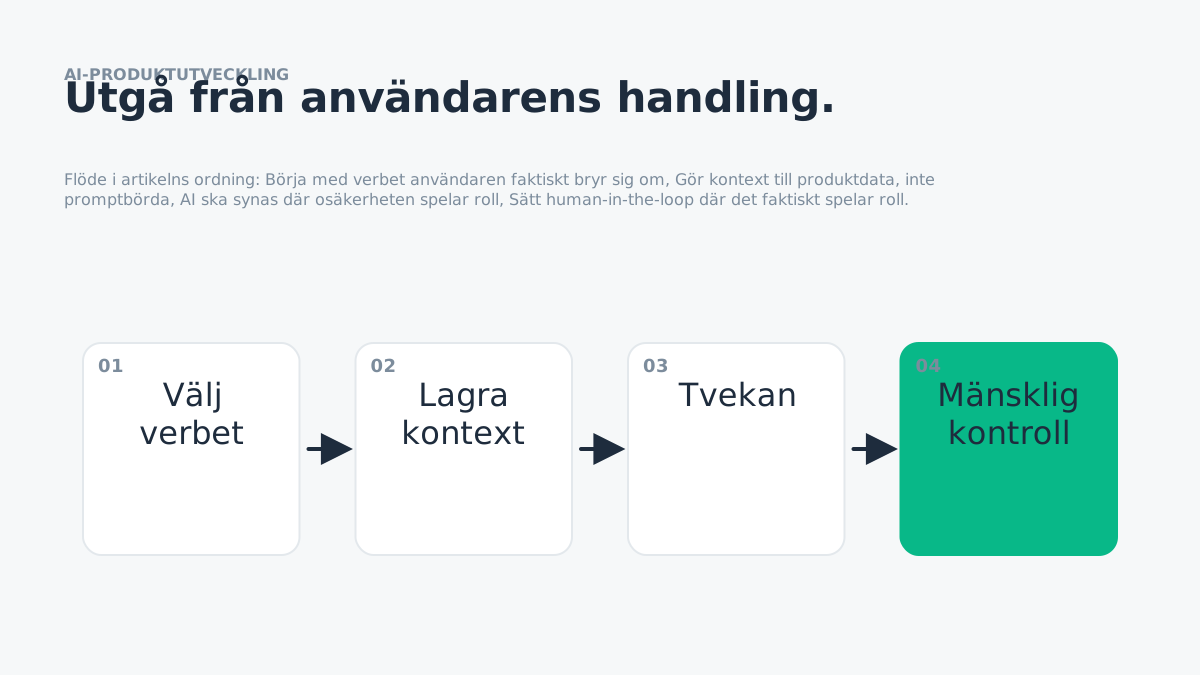
Börja med verbet användaren faktiskt bryr sig om
Ett chattfält är en generell primitive. Ett produktgränssnitt bör oftare börja i ett konkret verb: matcha, förbättra, kontrollera, öva, sammanfatta, jämför, publicera.
För en CV-tjänst är en knapp som säger "Matcha mot jobbet" ofta bättre än instruktionen "Fråga AI:n hur ditt CV passar annonsen". Den första formuleringen uttrycker ett jobb. Den andra uttrycker en teknik.
Jag brukar därför skriva ned tre saker innan jag ritar UI:
- Vad har användaren redan gett systemet?
- Vilket beslut eller resultat vill användaren komma till?
- Vilka val behöver verkligen göras av användaren, och vilka kan systemet härleda?
Om systemet redan har CV:t, jobbannonsen och användarens mål behöver gränssnittet inte fråga efter samma kontext igen i naturligt språk. Det är bara en extra promptkostnad som flyttats från utvecklaren till användaren.
Gör kontext till produktdata, inte promptbörda
Jag vill helst att viktig kontext kommer från strukturerade eller redan kända inputs. Ett CV kan extraheras till roller, datum, utbildning och färdigheter. En artikelbrief har redan titel, intent, canonical URL, first-hand evidence och kvalitetskrav. En utbildningssession har redan historik över vilka områden användaren klarat och missat.
Då kan modellen arbeta med ett tydligt kontrakt i bakgrunden:
Det är mycket lättare att testa än ett fritt "hjälp mig med mitt CV".
AI ska synas där osäkerheten spelar roll
Att gömma AI betyder inte att låtsas att systemet är deterministiskt. Tvärtom. Jag vill vara tydlig när modellen gör en bedömning som kan vara fel eller kräver användarens omdöme.
Jag skiljer därför på tre typer av output:
Fakta som systemet vet. Exempel: arbetsgivarnamn som faktiskt finns i CV:t.
Härledda observationer. Exempel: "den här erfarenheten verkar mest relevant för annonsens krav på kundkontakt".
Förslag. Exempel: en omskriven punkt som användaren måste godkänna.
De tre bör inte presenteras med samma visuella säkerhet. När allt ser lika definitivt ut skapar man ett förtroendeproblem senare.
Sätt human-in-the-loop där det faktiskt spelar roll
Jag lägger inte godkännande överallt bara för att modellen kan ha fel någonstans. Jag lägger det på steg där handlingen är irreversibel, har hög påverkan eller är svår att verifiera automatiskt i efterhand — till exempel innan ett CV skickas in eller en artikel publiceras. Andra steg får flöda vidare med loggning och möjlighet att ångra, i stället för ett extra klick som bara tröttar ut användaren utan att skydda mot något verkligt fel.
Det gör att fallback måste designas före wow-effekten, inte efteråt. Om modellen inte kan bedöma något ska produkten fortfarande kunna förklara vad som saknas och hur användaren går vidare — det är mer värdefullt i produktion än en spektakulär demo som bara fungerar på idealinput.
Jag undviker val som bara finns för att modellen kan dem
Generativa modeller kan producera tio toner, trettio format och hundratals varianter. Det betyder inte att produktens UI behöver exponera alla möjligheter.
Ett vanligt mönster är en vägg av inställningar: modell, temperatur, tonalitet, längd, kreativitet, persona och promptmall. För en power user kan det vara användbart. För en person som bara vill förbättra sitt CV är det mest en teknisk skuld förklädd till flexibilitet.
Jag försöker i stället ge ett litet antal produktval som motsvarar verkliga beslut. "Kortare", "mer konkret" och "behåll min ton" är begripligare än "temperature 0.4".
Progressiv kontroll fungerar bättre än full kontroll från start
Jag gillar ett mönster där produkten först gör ett rimligt standardjobb och sedan låter användaren korrigera. Inte tvärtom.
Första nivån kan vara en enkel rekommendation. Nästa nivå visar varför. Därefter kan en avancerad användare öppna fler kontroller. På så sätt behöver inte alla förstå systemets inre arkitektur för att få värde, samtidigt som den som vill kan gå djupare.
Det är samma tänk som progressive disclosure i andra tekniska system: visa komplexitet när den behövs, inte som inträdesbiljett.
Det viktigaste AI-UX-testet är inte om chatten känns smart
Jag vill hellre mäta om användaren kommer framåt utan att behöva lära sig modellen.
Några frågor jag använder:
- Hur många gånger behöver användaren formulera om sin intention?
- Hur ofta måste samma kontext matas in igen?
- Hur många genererade förslag används faktiskt?
- Var uppstår godkännanden och varför?
- Kan användaren förstå vad som kommer att hända innan en irreversibel handling sker?
- Kan systemet säga "jag kan inte avgöra det här" utan att användaren hamnar i en återvändsgränd?
Det sista är viktigt. En bra produktdesign gör abstention handlingsbar. Om modellen inte kan avgöra något bör UI:t säga vad som saknas och vad användaren kan göra härnäst.
Chat är bäst när jobbet faktiskt är konversation
Jag är inte emot chatt. Det är bra när intentionen är oklar, när följdfrågor är centrala eller när användaren vill utforska. Intervjuträning är ett bra exempel: samtalet är själva produkten. Samma sak kan gälla rådgivning eller en assistent som arbetar över många typer av uppgifter.
Men för återkommande, tydliga arbetsflöden försöker jag hellre kapsla in AI:n i produkten. Anthropic har beskrivit samma övergripande arkitekturprincip för agentiska system: använd den enklaste lösningen som löser uppgiften och lägg bara till mer autonomi när den ger mätbar nytta. OpenAI:s aktuella byggguide för agenter betonar på liknande sätt att man först ska kartlägga workflow, verktyg och evals, inte bara välja en modell. Anthropic: Building Effective Agents OpenAI: Building with GPT-5
Min nuvarande tumregel
Om en användare måste bli bättre på prompting för att bli bättre på själva produkten har jag sannolikt lämnat för mycket produktarbete ogjort.
Jag vill att AI:n ska bära variationen och komplexiteten, medan produkten gör intention, tillstånd och risk begripliga. Det är där jag tycker att AI börjar kännas som en riktig produktfunktion i stället för ett demofönster runt en modell.