Så gör jag research reproducerbar
Reproducerbar research betyder för mig inte att någon annan måste få exakt samma formulering från samma språkmodell. Det betyder att en annan person ska kunna förstå vilka frågor jag ställde, vilka källor jag använde, vad som sorterades bort, vilken version av underlaget som låg till grund för.
Reproducerbar research betyder för mig inte att någon annan måste få exakt samma formulering från samma språkmodell. Det betyder att en annan person ska kunna förstå vilka frågor jag ställde, vilka källor jag använde, vad som sorterades bort, vilken version av underlaget som låg till grund för slutsatsen och hur man kan köra om processen när källorna ändras. Det är framför allt provenance och arbetsdisciplin, inte en magisk seed.
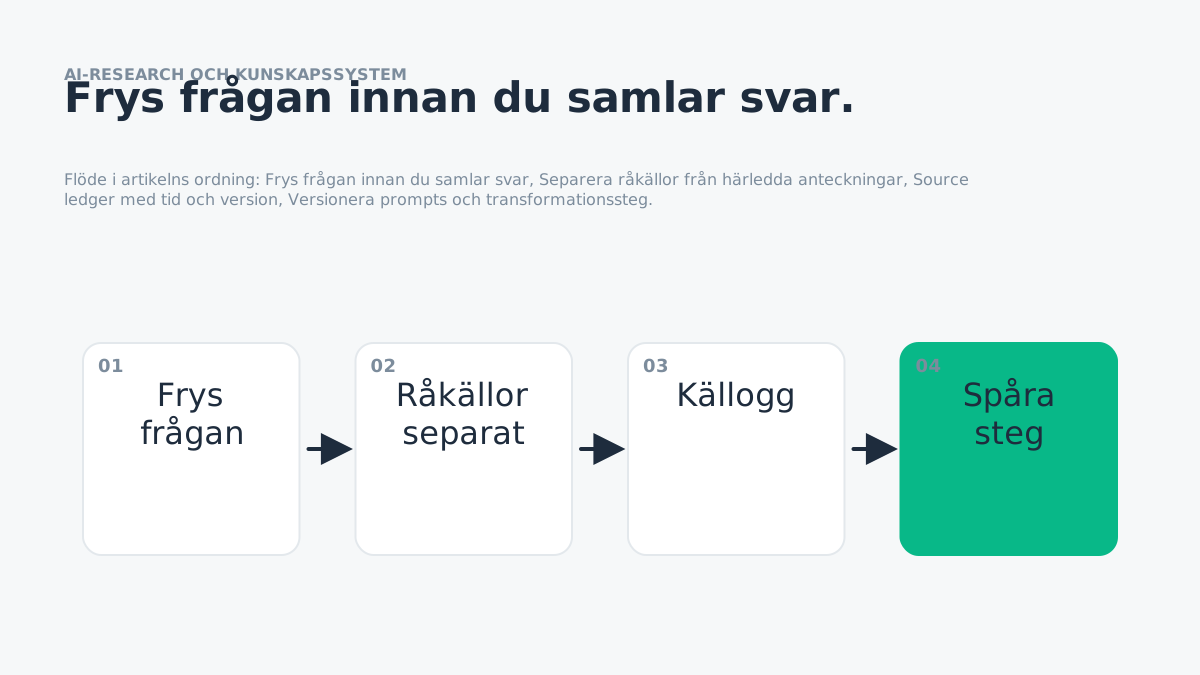
Frys frågan innan du samlar svar
Jag börjar med scope, beslutsfråga och inklusionskriterier. Om frågan ändras mitt i researchen loggar jag det som en ny iteration i stället för att låta den glida obemärkt. Det praktiska värdet är spårbarhet: jag vill kunna återvända till beslutet senare och se om systemet fortfarande beter sig som avsett, i stället för att förlita mig på minnet av varför en regel lades till.
Separera råkällor från härledda anteckningar
Originalfiler, snapshots och URL-metadata ligger separat från summaries, claims och slutsatser, så att det går att kontrollera om en tolkning faktiskt finns i källan. Jag brukar testa principen med ett negativt fall, inte bara ett lyckat exempel: om flödet ändå passerar när förutsättningen saknas är kontrollen för svag och behöver flyttas uppströms eller göras deterministisk.
Source ledger med tid och version
För varje källa sparar jag URL eller fil-ID, titel, publicerings-/uppdateringsdatum när det finns, retrieval date och vilken claim den stödjer. Tidskänsliga källor får freshness-flagga. Det här påverkar även kostnaden: när processen är explicit kan enklare steg köras med enklare verktyg eller modeller, och de dyra bedömningarna reserveras för de delar där osäkerheten faktiskt finns.
Versionera prompts och transformationssteg
Om AI används för extraktion eller klassificering sparar jag instruktionen och outputformatet. Jag behöver inte spara privat chain-of-thought – bara den exekverbara uppgiften och resultatet. Det viktiga är att inte göra regeln bredare än problemet: jag dokumenterar därför scope och undantag samtidigt som jag dokumenterar huvudregeln, annars tenderar en lokal lösning att bli global policy av gammal vana.
Gör beslut explicit
Exkluderade källor och conflict states dokumenteras. Annars ser den färdiga researchen renare ut än processen faktiskt var, och en senare granskare kan inte förstå varför två källor behandlades olika. I ett agentflöde blir ägarskapet centralt av samma anledning: nästa steg ska inte behöva tolka en lång chattlogg för att förstå vad som är godkänt, det ska få ett litet kontrakt med input, evidens, beslut och återstående osäkerhet.
Reproducerbarhet kräver miljödata när kod ingår
Kodversion, dependencies, inputdata och parametrar hör till artefakten. OSF rekommenderar bland annat att skilja rådata från derived data och kod från data samt att använda versionshantering. Det här är också där jag skiljer demo från drift: i en demo räcker det ofta att output ser rimligt ut, men i drift måste samma resultat gå att förklara, validera och vid behov stoppa utan att en människa läser hela resonemanget.
Snapshot när beslutet tas
När ett researchpaket används för publicering eller en större produktändring skapar jag ett fryst snapshot. OSF-registreringar illustrerar samma princip: ett tidsstämplat, låst tillstånd gör det möjligt att se vad som faktiskt var känt vid beslutstillfället. En bieffekt är att förbättringar blir enklare att mäta – när samma testfall och artefakter finns kvar kan jag ändra en komponent i taget och se om kvaliteten faktiskt gick upp eller om jag bara flyttade felet.
Reproducible betyder inte permanent sant
En perfekt reproducerbar analys kan bli inaktuell. Därför skiljer jag mellan reproducibility och freshness: det ena visar hur slutsatsen skapades, det andra om underlaget fortfarande gäller. Jag vill dessutom att en framtida person ska kunna ta över – om metoden bara fungerar när skaparen minns alla muntliga undantag är den inte riktigt produktionsmässig, oavsett hur bra modellen är i dag.
Ett litet exekverbart kontrakt
Jag försöker alltid kondensera metoden till ett kontrakt som går att implementera eller granska, med fält för input, evidence, decision, owner, next_state och release_condition. Jag beskriver den fulla mallen och varför inget fält får fyllas i med sådant modellen hittar på i min checklista för att flytta ett AI-workflow från prototyp till produktion.
Ett minimalt researchpaket
För ett vanligt BijoyIQ-case vill jag kunna lägga hela researchens provenance i en liten mapp: question.md med scope och beslutskriterier, sources.csv med source IDs och retrieval-datum, claims.csv med claim→source-mappning, notes/ för härledda anteckningar och decision.md för slutsatsen inklusive osäkerheter. Om kod används lägger jag till scripts/, dependency-information och inputdata eller en pekare till dess version. Det räcker långt för att en senare körning ska kunna förstå vad som måste återskapas.
När språkmodeller är med sparar jag den faktiska instruktionen, modellidentifierare där det är relevant och strukturerat output. Jag behöver inte spara privat resonemang. Det reproducerbara objektet är uppgiften som gavs till modellen, de källor den fick använda och det resultat som sedan granskades.
Re-run-policy för research som blir gammal
Alla källor åldras inte lika snabbt. Produktfunktioner, API-beteenden, priser, lagar och myndighetsregler får kortare freshness-fönster än historiska eller metodologiska källor. När ett fönster löper ut behöver jag inte skriva om hela artikeln; jag kan börja med att identifiera vilka claims som beror på den källan och köra om just den delen. Det är här provenance betalar sig. Reproducerbarheten gör uppdatering selektiv i stället för att varje ändring kräver ny research från noll.