Så matchar jag ett CV mot en jobbannons med AI
CV-matchning låter enkelt som prompt: "Jämför det här CV:t med annonsen och ge ett score." Jag tycker score är den minst intressanta delen. Det användbara är att kunna förklara var matchen finns, var gapet finns och vad kandidaten faktiskt kan göra åt det.
CV-matchning låter enkelt som prompt: "Jämför det här CV:t med annonsen och ge ett score." Jag tycker score är den minst intressanta delen. Det användbara är att kunna förklara var matchen finns, var gapet finns och vad kandidaten faktiskt kan göra åt det.
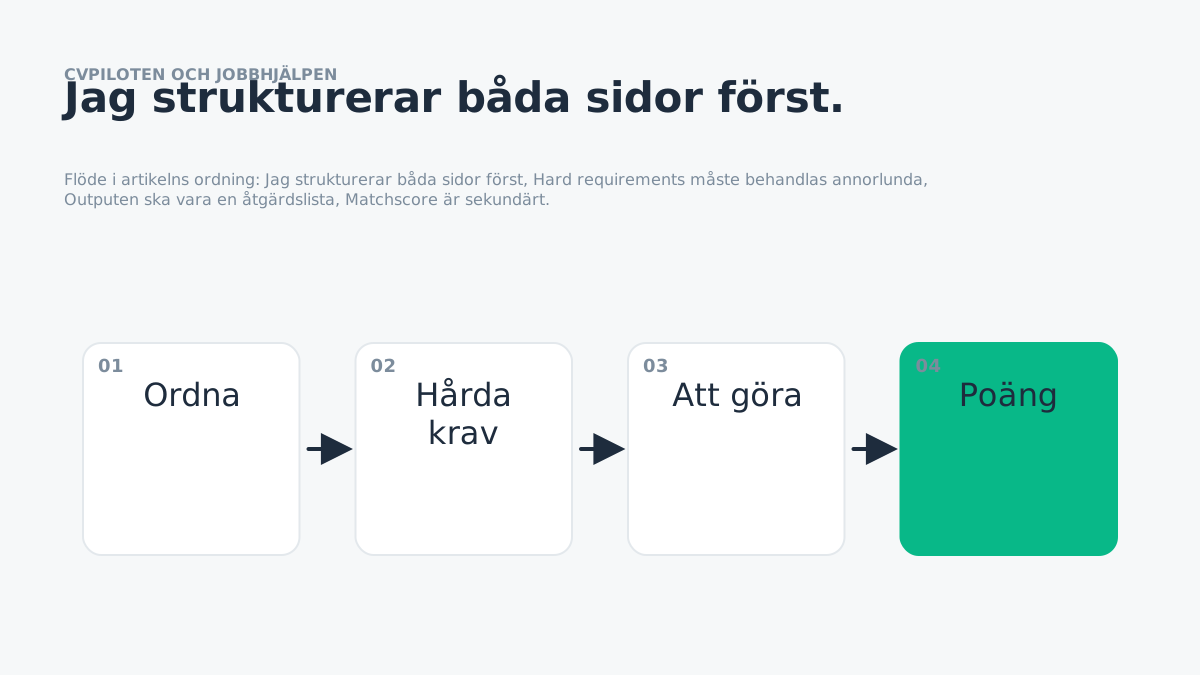
Jag strukturerar båda sidor först
Jobbannonsen delas upp i krav, meriterande kriterier, arbetsuppgifter, domänord och signaler om senioritet. CV:t delas upp i verifierade erfarenheter och kompetenser.
Sedan matchar jag relationer mellan dem, inte bara ord. "Hantera kunder" kan vara relevant för "kunddialog". "Planera schema" kan signalera koordinering även om annonsen använder ett annat ord. Här är LLM:n bättre än ren keyword matching.
Hard requirements måste behandlas annorlunda
Alla träffar är inte lika. Körkort, legitimation eller ett uttryckligt språkkrav kan vara binära krav. Där ska modellen inte ge 80 procents "semantisk match" och låtsas att det räcker.
Jag vill därför ha olika resultattyper:
Det sista är viktigt. Ett CV innehåller sällan allt personen kan.
Outputen ska vara en åtgärdslista
En användbar matchning bör säga:
- vilka delar som redan är starka,
- vilka erfarenheter som bör flyttas upp,
- vilka relevanta fakta som är för svagt beskrivna,
- vilka krav som saknar evidens,
- vilka frågor användaren bör svara på innan CV:t uppdateras.
Europass rekommenderar att erfarenheter anpassas till jobbet och att man fokuserar på fakta och huvudpunkter som matchar annonsen. Det är nära den produktprincip jag vill åt: AI ska hjälpa kandidaten att välja och formulera rätt sanning, inte skapa en bättre fiktiv kandidat.
Matchscore är sekundärt
Jag kan fortfarande visa en sammanfattande indikator i UI:t, men internt vill jag inte att ett enda tal blir sanningen. Ett 73-procentigt score utan förklaring är svårt att agera på och skapar falsk precision.
Den riktiga produkten är gap-analysen och de verifierbara förbättringarna.