Så promptar jag AI att inte bara hålla med mig
Jag vill inte ha en AI som alltid håller med mig. Jag vill inte heller ha en AI som spelar djävulens advokat för sakens skull. Det användbara läget är när den kan skilja min premiss från evidensen och visa exakt vad som skulle få slutsatsen att ändras.
Jag vill inte ha en AI som alltid håller med mig. Jag vill inte heller ha en AI som spelar djävulens advokat för sakens skull. Det användbara läget är när den kan skilja min premiss från evidensen och visa exakt vad som skulle få slutsatsen att ändras.
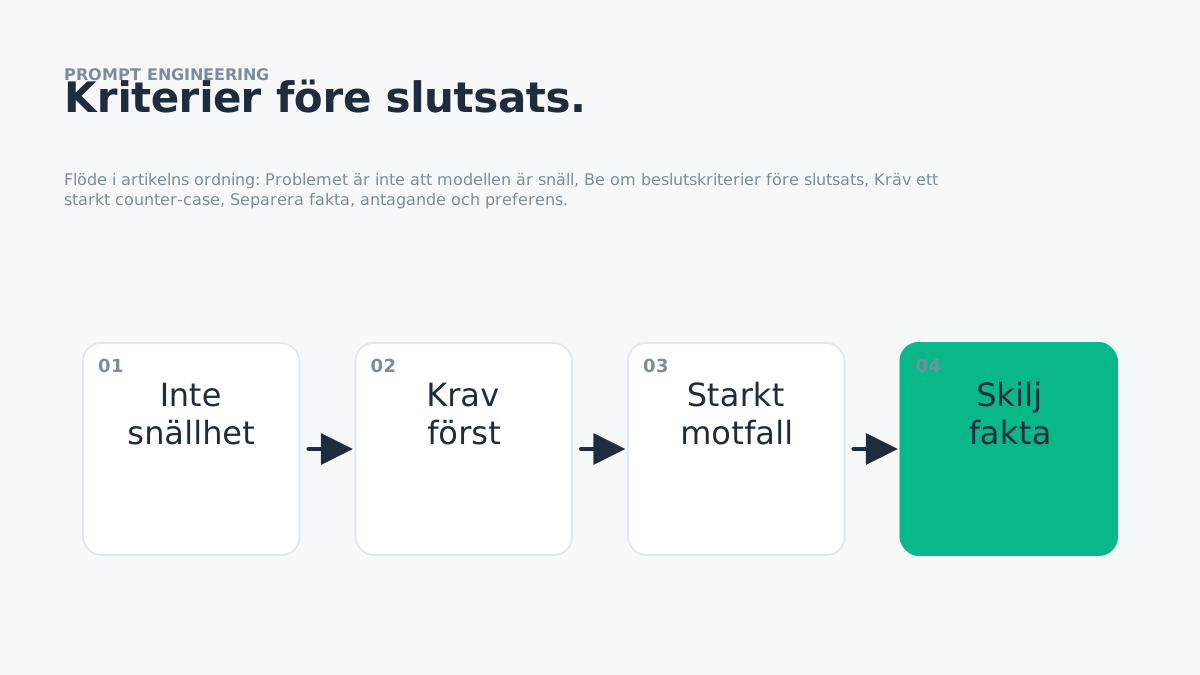
Problemet är inte att modellen är snäll
När jag säger att jag inte vill att AI ska hålla med mig menar jag inte att den ska vara motvalls. Jag vill att den ska skilja på min premiss och beviset för premissen. Ett svar som reflexmässigt säger ja är dåligt, men ett svar som reflexmässigt säger nej är lika oanvändbart.
Be om beslutskriterier före slutsats
Ett enkelt sätt att minska medhåll är att definiera kriterier innan modellen ser vilket alternativ jag föredrar. Exempel: värdera en arkitektur på reversibilitet, driftsrisk, kostnad, komplexitet och testbarhet. Sedan får modellen bedöma alternativen mot samma matris.
Kräv ett starkt counter-case
Jag ber modellen formulera det starkaste rimliga argumentet mot min föreslagna lösning och ange vilken evidens som skulle få den att ändra slutsats. Det ger mer än 'för- och nackdelar' eftersom reviewern måste definiera vad som faktiskt är beslutspåverkande.
Separera fakta, antagande och preferens
Jag vill att reviewn märker påståenden som VERIFIED, ASSUMPTION eller PREFERENCE. Många designkonflikter ser tekniska ut men är egentligen preferenser. När de markeras blir det svårare för modellen att paketera min egen smak som objektiv best practice.
Använd rubriker som tvingar fram friktion
Mitt reviewformat kan innehålla What I disagree with, What would break this, What is underspecified och What I would keep. Balansen är viktig. Om reviewern bara får leta fel kommer den till slut hitta på fel för att uppfylla rollen.
Evals slår retorik
När en prompt eller agent ska förbättras vill jag hellre ha ett litet eval-set än en lång diskussion om vilken formulering som 'känns bättre'. OpenAI rekommenderar i sin guide till GPT-5 att prompt tuning börjar med evals och att man itererar systematiskt mot konkreta failure cases. Det flyttar samtalet från medhåll till mätbar beteendeförändring.
Bra motstånd slutar i ett beslut
Review är inte en debattklubb. Efter kritik behöver vi ett beslut: accept, change, test eller defer. Då blir AI:n en användbar motpart snarare än en bekräftelsemaskin.
Min praktiska tumregel
Be om kriterier, counter-case och ändringsvillkor — inte bara “var kritisk”.