Så versionshanterar jag AI Skills
Jag versionshanterar AI Skills mer som programvara än som dokument. Anledningen är enkel: en liten ändring i en description, en stoppregel eller ett eval kan förändra beteendet lika mycket som en kodändring.
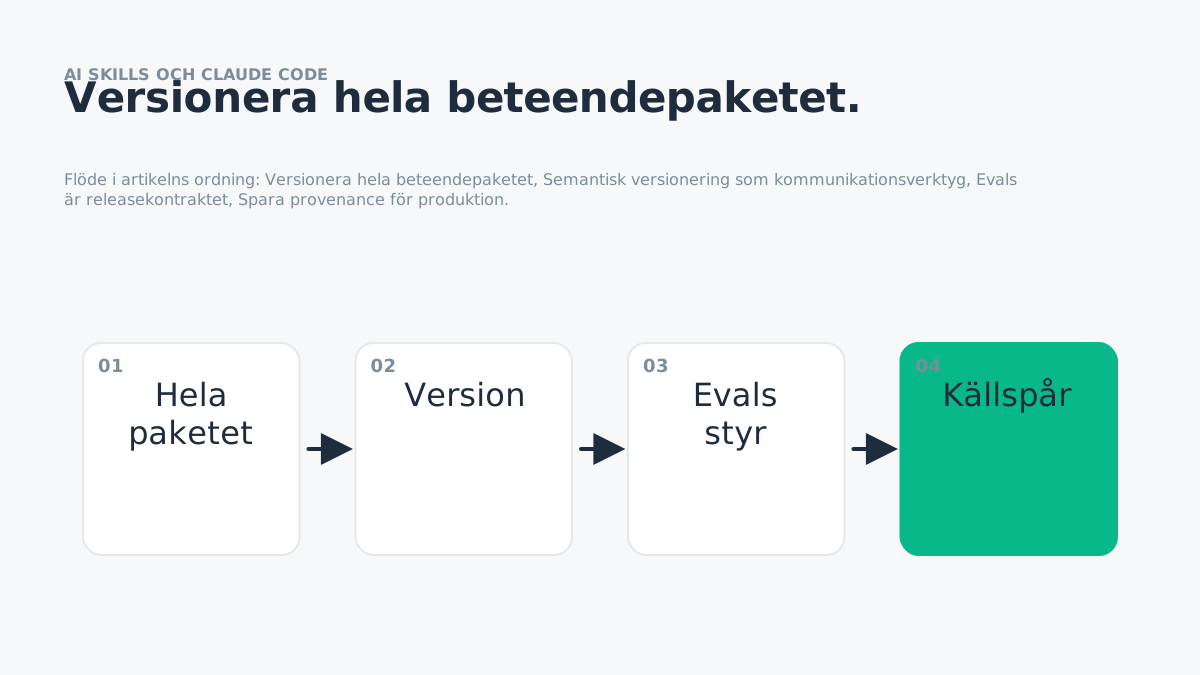
Jag versionshanterar AI Skills mer som programvara än som dokument. Anledningen är enkel: en liten ändring i en description, en stoppregel eller ett eval kan förändra beteendet lika mycket som en kodändring. Om jag bara sparar ‘senaste SKILL.md’ tappar jag förmågan att svara på vilken version som producerade ett visst resultat, vad som ändrades och om en regression kom från modellen eller från mina egna instruktioner.
Versionera hela beteendepaketet
SKILL.md räcker inte. References, scripts, evals och fixtures hör till samma release. Jag vill kunna checka ut en commit och återskapa den Skill som faktiskt kördes. Det praktiska värdet är spårbarhet: jag vill kunna återvända till beslutet senare och se om systemet fortfarande beter sig som avsett, i stället för att förlita mig på minnet av varför en regel lades till.
Semantisk versionering som kommunikationsverktyg
Jag använder major för brutna kontrakt eller ändrat scope, minor för nya kompatibla capabilities och patch för lokala korrigeringar. Det viktiga är inte siffrorna utan att release-noten beskriver beteendeförändringen. Jag testar därför principen mot minst ett negativt fall, inte bara ett lyckat exempel: om flödet ändå passerar när förutsättningen saknas är kontrollen för svag och behöver flyttas uppströms eller göras deterministisk.
Evals är releasekontraktet
Före merge körs golden cases och tidigare incidents. En version är inte godkänd bara för att instruktionen ser bättre ut i diffen; beteendet måste klara samma verifierbara fall. Det här påverkar också kostnaden: när processen är explicit kan enklare steg köras med enklare verktyg eller modeller, och de dyra bedömningarna reserveras för de delar där osäkerheten faktiskt finns.
Spara provenance för produktion
När en artikel eller annan artefakt skapas sparar jag skillversion, modell, datum och relevanta source-versioner i metadata. Då går det att felsöka efteråt utan gissningar. Det viktiga är att inte göra regeln bredare än problemet, så jag dokumenterar scope och undantag samtidigt som jag dokumenterar huvudregeln; annars tenderar en lokal lösning att bli global policy av gammal vana.
Ändra inte rules och evals i samma mörker
Om jag både ändrar instruktionen och byter evalset samtidigt kan en förbättrad score vara meningslös. Jag försöker hålla referensfallen stabila och lägga till nya incidents som separata, dokumenterade förändringar. I ett agentflöde blir ägarskapet centralt: nästa steg ska inte behöva tolka en lång chattlogg för att förstå vad som är godkänt, det ska få ett litet kontrakt med input, evidens, beslut och återstående osäkerhet.
Deprecation i stället för tyst omskrivning
När ett beteende fasas ut märker jag det och anger migration. Det är särskilt viktigt när andra agenter eller projekt förutsätter gamla outputfält eller states. Det är också här jag försöker skilja demo från drift: i en demo räcker det ofta att output ser rimligt ut, i drift måste samma resultat gå att förklara, validera och vid behov stoppa utan att en människa läser hela resonemanget.
Modelluppdateringar är externa dependencies
Även en oförändrad Skill kan bete sig annorlunda på en ny modell. Därför kör jag regressioner vid större modellbyten och loggar modellversion separat från Skill-version. En bieffekt är att förbättringar blir enklare att mäta: när samma testfall och artefakter finns kvar kan jag ändra en komponent i taget och se om kvaliteten faktiskt gick upp eller om jag bara flyttade felet.
Min releasefil
Varje release bör kunna svara på: vad ändrades, varför, vilka evals kördes, vilka kända begränsningar finns och hur backar vi tillbaka? Det är tillräckligt för att göra förbättringar granskningsbara. Jag vill dessutom att en framtida person ska kunna ta över: om metoden bara fungerar när skaparen minns alla muntliga undantag är den inte riktigt produktionsmässig, oavsett hur bra modellen är i dag.
Ett litet exekverbart kontrakt
Jag kondenserar metoden till ett litet exekverbart kontrakt av samma slag som jag beskriver i checklistan innan ett AI-workflow får gå från prototyp till produktion — här specialiserat för release av en Skill-version.
En release behöver ett beteendediff, inte bara ett textdiff
Git kan visa att tre rader ändrades i SKILL.md. Det säger inte om triggern nu fångar fler uppgifter, om en blocker flyttades eller om editorn har fått rätt att förändra något den tidigare bara fick kommentera. Därför skriver jag en kort beteendediff: “före: saknad primärkälla gav QUALIFIED; efter: samma fall blir BLOCKED” eller “före: Skillen laddade alltid tre referenser; efter: SEO-referensen laddas endast vid publiceringsuppdrag”. Det är den typen av förändring som andra delar av systemet behöver förstå.
Jag sparar också minst ett exempel som visar varför releasen behövdes. När en incident senare liknar den gamla kan vi se om fixen faktiskt borde ha fångat den. Det blir en liten incidenthistorik inbyggd i versionshanteringen.
Rollback är en feature
En ny Skill-version kan fungera bättre på genomsnittet och ändå bryta ett kritiskt edge case. Därför vill jag kunna rulla tillbaka instruktioner, scripts och referenser som ett paket. Om en release dessutom kräver schemaändringar eller nya outputfält dokumenterar jag migrationen. Det är samma disciplin som i annan mjukvara: kompatibilitet är inte något en språkmodell kan resonera fram i efterhand när konsumenter redan förväntar sig ett gammalt kontrakt.
Slutsats
Versionshantering gör Skills mindre mystiska. När beteende, evals och källor kan kopplas till en release går det att behandla regressioner som ingenjörsproblem i stället för som “modellen känns annorlunda”. Det är den nivå av kontroll jag vill ha innan en Skill får bli infrastruktur.