Hur jag bygger en single source of truth för AI-genererat innehåll
När AI bara skriver ett utkast kan sanningen ligga i huvudet på personen som granskar. När samma system producerar hundratals artiklar räcker det inte. Jag behöver veta vilken källa, vilket claim och vilken version som ligger bakom varje materiellt påstående.
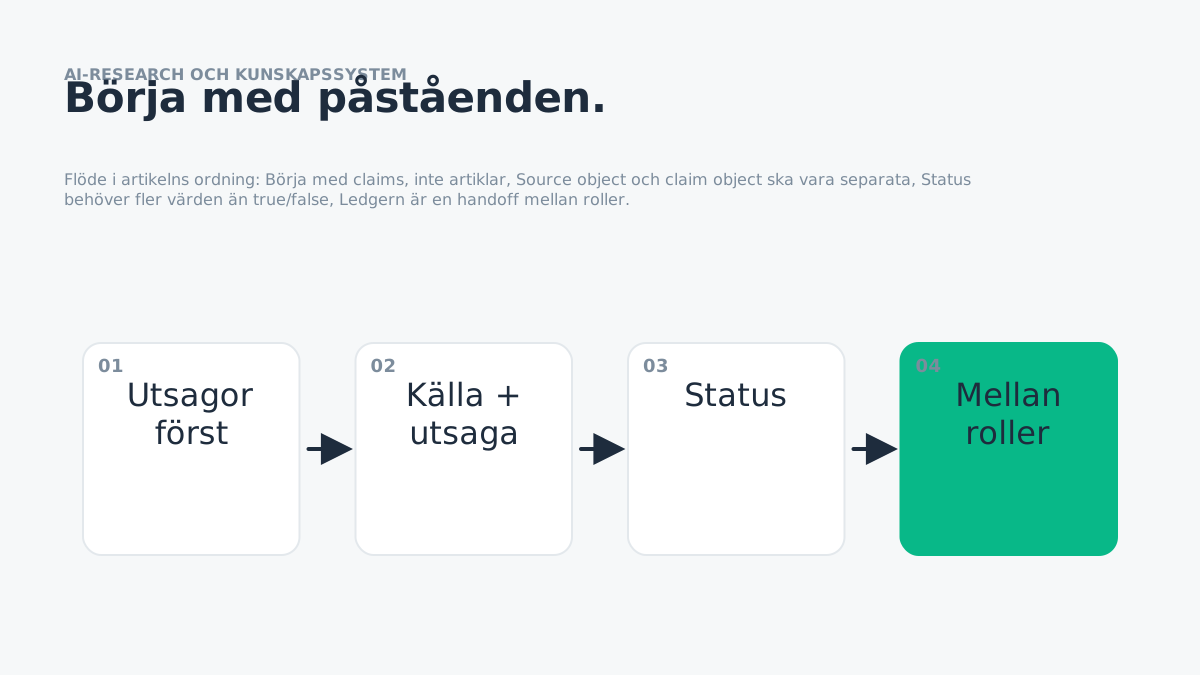
När AI bara skriver ett utkast kan sanningen ligga i huvudet på personen som granskar. När samma system producerar hundratals artiklar räcker det inte. Jag behöver veta vilken källa, vilket claim och vilken version som ligger bakom varje materiellt påstående.
Det är därför jag ser single source of truth som en datamodell, inte som ett dokument där "allt viktigt" har klistrats in.
Börja med claims, inte artiklar
En artikel är för stor som sanningsenhet. Samma regel kan förekomma i tio artiklar, och en artikel kan innehålla femtio oberoende fakta.
Jag modellerar därför ungefär:
Artikeln pekar på claims. Claims pekar på sources. Det gör uppdatering möjlig i båda riktningar.
Source object och claim object ska vara separata
En URL är inte ett claim. Samma myndighetssida kan stödja flera påståenden och ändras över tid.
Source-registret behöver därför metadata:
Sedan kopplar evidence ledger ett claim till den del av källan som faktiskt bär det.
Status behöver fler värden än true/false
Jag använder hellre:
VERIFIED,QUALIFIED,UNRESOLVED,CONFLICT,REMOVED.
Det gör undantag och konflikter maskinläsbara. En writer får bara använda claims som passerar den policy som gäller för artikeltypen.
Ledgern är en handoff mellan roller
Det här statusschemat fungerar bara om det faktiskt äger ett steg i arbetsflödet, inte bara en kolumn i en tabell. Jag ser evidence ledger som en handoff: researchern fyller på underlag, en evidence auditor avgör om det räcker för att sätta status, och writer får bara använda claims som redan är godkända. Minsta fält jag vill ha per rad är claim_id, claim_text, källa, retrieved_at, verdict och en notering — för tidskänsligt material tillkommer en freshness-risk, och för first-hand claims en provenance till ett faktiskt projektunderlag.
Det gör ledgern till ett gränssnitt mellan roller i stället för en fotnot som klistras på i efterhand, och det är den skillnaden som gör fakta spårbara i ett system som producerar många artiklar snarare än en i taget.
Versionera sanningen
"Single source of truth" betyder inte att sanningen aldrig förändras. Tvärtom behöver systemet kunna veta vilken version som var giltig när.
Om en regel ändras den 1 januari vill jag inte skriva över den gamla posten och förlora historiken. Jag vill kunna se:
Då går det att både uppdatera framtida content och förstå varför en äldre publicerad text såg ut som den gjorde.
Content ska kompileras från sanningslagret
I stället för att faktagranska samma regel i varje artikel vill jag att många artiklar kan referera till samma verifierade claim.
När C104 förändras får jag en impact list över vilka URL:er som behöver recheck. Det ger betydligt mer än en kalenderpåminnelse om att "uppdatera gamla artiklar".
First-hand evidence är en separat källa
Allt i BijoyIQ kommer inte från externa URL:er. Många artiklar bygger på faktiska implementationer, versioner och fel vi har sett i systemen.
Jag behandlar därför first-hand evidence som egna objekt:
Det hindrar "jag har märkt att..." från att bli en fri licens att hitta på erfarenheter.
Hashar hjälper när källor ändras
För webbkällor och egna artefakter kan en content hash hjälpa till att upptäcka förändring. Hashen bevisar inte att källan är sann, men den kan visa att bytes har ändrats sedan senaste verifieringen.
Samma princip gäller draften i sig, inte bara källan. När fact checker godkänner ett utkast kan systemet spara hashen för den godkända versionen; ändras texten efter godkännandet ser Publisher Gate att hashen inte längre matchar och kräver ny kontroll innan publicering. I multi-agent-flöden loggar jag därför input- och output-hash vid varje handoff tillsammans med article_id, stage, source version och tidsstämpel — hashen blir en del av provenance, inte ett ensamt kryptografiskt nummer utan kontext. Det är ett bra exempel på att använda deterministisk kod runt modellen.
Publisher Gate läser truth state
Jag vill inte att Publisher Gate "tycker" att artikeln verkar trovärdig. Den ska kunna kontrollera:
Sedan kan en LLM-review bedöma nyans och formulering.
Single source of truth är inte samma sak som en vector database
Embeddings och retrieval kan hjälpa mig hitta rätt material, men de är inte själva sanningsmodellen. En vector store berättar vilka chunks som liknar frågan. Den berättar inte automatiskt vilket claim som är gällande version eller om två myndighetskällor är i konflikt.
Jag behöver därför både retrieval och explicit struktur.
Underhåll blir en produktfunktion
När sanningslagret finns kan jag bygga automatiska underhållsflöden:
Då är content-systemet inte bara en fabrik för nya URL:er. Det är ett system som kan hålla gamla URL:er korrekta.
Min definition av SSOT
För AI-content betyder single source of truth för mig inte "ett dokument modellen alltid läser". Det betyder:
ett versionshanterat, spårbart lager där varje viktigt påstående har källa, status, scope, freshness och beroenden.
När det lagret finns kan modeller bytas, prompts förändras och artiklar skrivas om utan att sanningen behöver uppfinnas på nytt varje gång.
Varför det också är en content-kvalitetsfråga
Google lyfter originalinformation, tydlig sourcing och first-hand expertise som delar av people-first content. Ett strukturerat sanningslager löser inte SEO i sig, men det gör det möjligt att visa var materialet kommer ifrån och hålla samma sakuppgift konsekvent över flera sidor. Google Search Central: Creating helpful, reliable, people-first content.
Relaterade artiklar
- Jag genererade 220 artiklar med AI — här är problemet jag underskattade
- Research layer vs writing layer: varför jag separerar dem
- Content generation vs content production — en viktig skillnad
- Så extraherar jag regler, principer och undantag ur forskning
- Så kopplar jag varje faktapåstående till en primärkälla