Så extraherar jag regler, principer och undantag ur forskning
Det svåra med att göra en Skill från forskning är inte att sammanfatta paperet. Det svåra är att avgöra vad som faktiskt får bli en operativ regel. Ett statistiskt fynd, en forskares hypotes och en redaktionell rekommendation är tre olika saker.
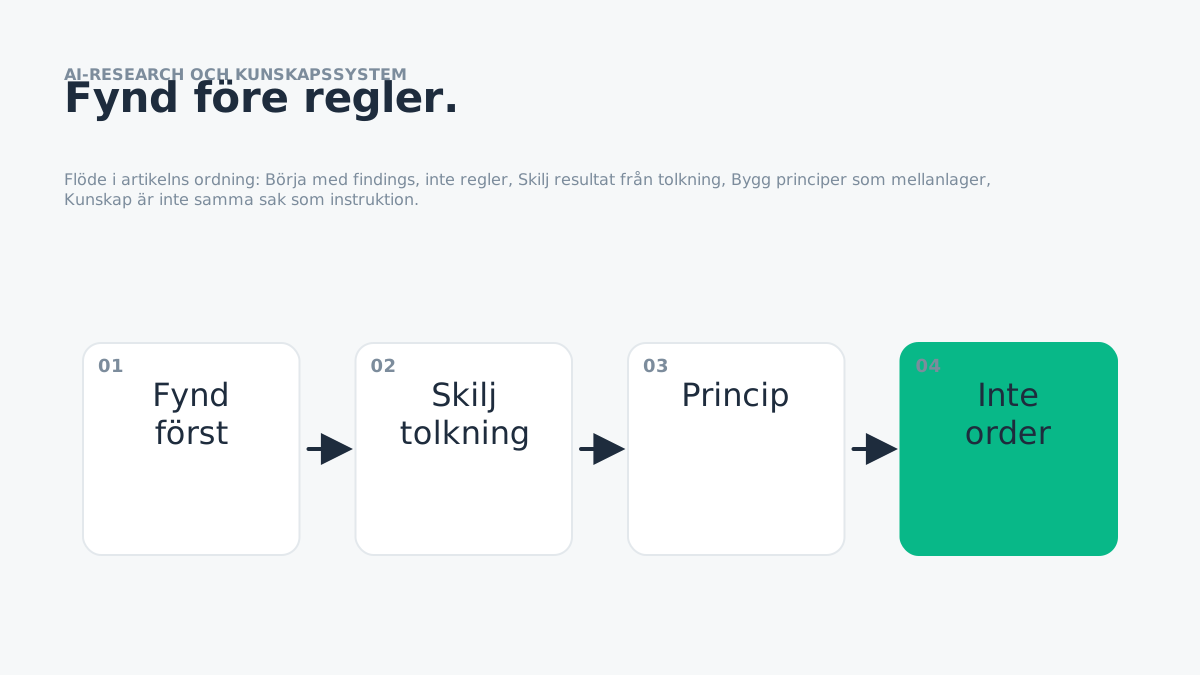
Det svåra med att göra en Skill från forskning är inte att sammanfatta paperet. Det svåra är att avgöra vad som faktiskt får bli en operativ regel. Ett statistiskt fynd, en forskares hypotes och en redaktionell rekommendation är tre olika saker. Om de blandas ihop kan ett försiktigt resultat bli en absolut instruktion efter bara två transformationssteg.
Jag använder därför en kompilatorliknande kedja: source → finding → principle → rule → eval.
Börja med findings, inte regler
Första artefakten efter läsningen är en lista med findings. Varje finding ska beskriva vad källan faktiskt visar och vilken avgränsning som gäller.
Exempel:
Jag skriver alltså inte direkt "undvik X". Den operativa konsekvensen kommer senare.
Skilj resultat från tolkning
Ett forskningspaper innehåller flera röster samtidigt: data, författarnas tolkning och mina egna slutsatser.
Jag märker dem separat:
- OBSERVED: direkt resultat i data/experiment,
- AUTHOR INTERPRETATION: forskarnas förklaring,
- DERIVED PRINCIPLE: min försiktiga operationalisering,
- EDITORIAL RULE: praktisk tumregel som inte ska säljas som forskning.
Det är ett enkelt sätt att stoppa evidensdrift.
Bygg principer som mellanlager
Principen är bron mellan forskning och instruktion. Den ska vara bred nog att återanvändas men fortfarande bära forskningsscopen.
Om ett paper exempelvis visar att en viss korpus överförklarar teman mer kan principen vara:
Redundant temaförklaring kan granskas när scen, dialog och narrator säger samma sak.
Det är något helt annat än:
AI överförklarar. Ta bort tematiska meningar.
Den första principen kräver ett observerbart problem i den aktuella texten. Den andra gör ett gruppresultat till universell regel.
Kunskap är inte samma sak som instruktion
Ett källregister löser bara halva problemet. En lista med papers och dokumentation säger vad systemet kan luta sig mot, men inte vilket beteende som ska följa. "Forskningen visar X" är kunskap. "När X observeras i denna genre, gör Y men bevara Z" är en instruktion — och det är just den transformationen jag vill åt innan ett fynd får styra en Skill.
Undantag är del av regeln
Jag vill helst att varje operativ regel innehåller fyra delar:
Exempel:
Utan exceptions blir en korrekt regel snabbt en dålig automation.
Negativa fynd är också regleringsdata
Jag extraherar inte bara "vad som fungerade". Null-resultat och robustness checks kan vara ännu viktigare.
Om en studie inte hittar någon topicskillnad betyder det inte att "topic aldrig spelar roll". Men det kan stoppa mig från att skapa en regel som hävdar att ett visst resultat beror på topic.
På samma sätt kan en ablation visa att ingen enskild feature är nödvändig. Då ska jag vara försiktig med att bygga ett system runt en enda tell.
Evidensstyrka behöver en separat etikett
Alla regler i en Skill ska inte låtsas ha samma stöd. Jag använder kategorier som:
- CORE: trohets- eller kvalitetskrav som har bred motivering,
- CONDITIONAL: används bara inom en tydlig trigger/scope,
- EXPERIMENTAL: plausibel operationalisering som behöver mer test,
- EDITORIAL: redaktionell regel som inte är ett forskningsfynd.
Det här gör Skillen ärligare och lättare att uppdatera.
Testet kommer före release
När en regel formulerats bygger jag minst ett positivt och ett negativt testfall.
Negativfallen är ofta det som hindrar övergeneralisering.
Exempel från Humanizer-arbetet
StoryScope-studien hittar bland annat skillnader i tematisk explicithet, embodied emotion och narrativ struktur mellan grupper i sin korpus. Men studien gäller specifik lång fiktion, och feature-skillnaderna är probabilistiska gruppresultat. StoryScope.
I Humanizern betyder det att jag kan skapa en conditional regel för redundant temaförklaring i fiktion. Jag kan inte skapa en global regel som säger att all svensk AI-sakprosa ska få mindre explicita slutsatser.
Den skillnaden är själva kärnan i research-to-rule-kompileringen.
Samma kompilering gäller för böcker, inte bara papers
Metodik ur en bok kräver samma disciplin, fast med en annan läsart. En bokresumé är inte en metod — en metod behöver dessutom beslutspunkter, ordning, input, output, felmoder och kriterier för när steget inte ska användas. När jag läser för metod markerar jag verb och villkor: "börja med", "om X, gör Y", "undvik när" och "kontrollera därefter". Böcker använder ofta ett exempel för att förklara en princip, och jag vill bevara principen utan att göra det specifika caset till en universell regel. Där expertlitteraturen hoppar över steg som författaren tar för givet markerar jag i stället att steget saknar stöd, i stället för att låta modellen fylla luckan med en påhittad regel.
En regel ska kunna backas ur
Varje regel behöver provenance. Om en källa senare visar sig svag, en modellgeneration förändras eller ny forskning motsäger resultatet ska jag kunna hitta alla beroenden.
Då kan jag avaktivera R010 och dess tester utan att skriva om hela Skillen.
Det är versionshantering av kunskap, inte bara av filer.
Min releasefråga
Innan ett researchfynd får styra en modell frågar jag:
Kan jag formulera trigger, action, undantag, evidensstatus och ett negativt testfall utan att överdriva vad källan visar?
Om svaret är nej är materialet kanske intressant research, men det är ännu inte en produktionsregel.