Från PDF till expertagent: ett praktiskt arbetsflöde
Från PDF till expertagent: ett praktiskt arbetsflöde handlar för mig mindre om en enskild prompt och mer om hur man gör ett återkommande AI-arbete granskningsbart. När jag bygger för egen produktion försöker jag därför göra antaganden, evidens, state och stoppregler synliga.
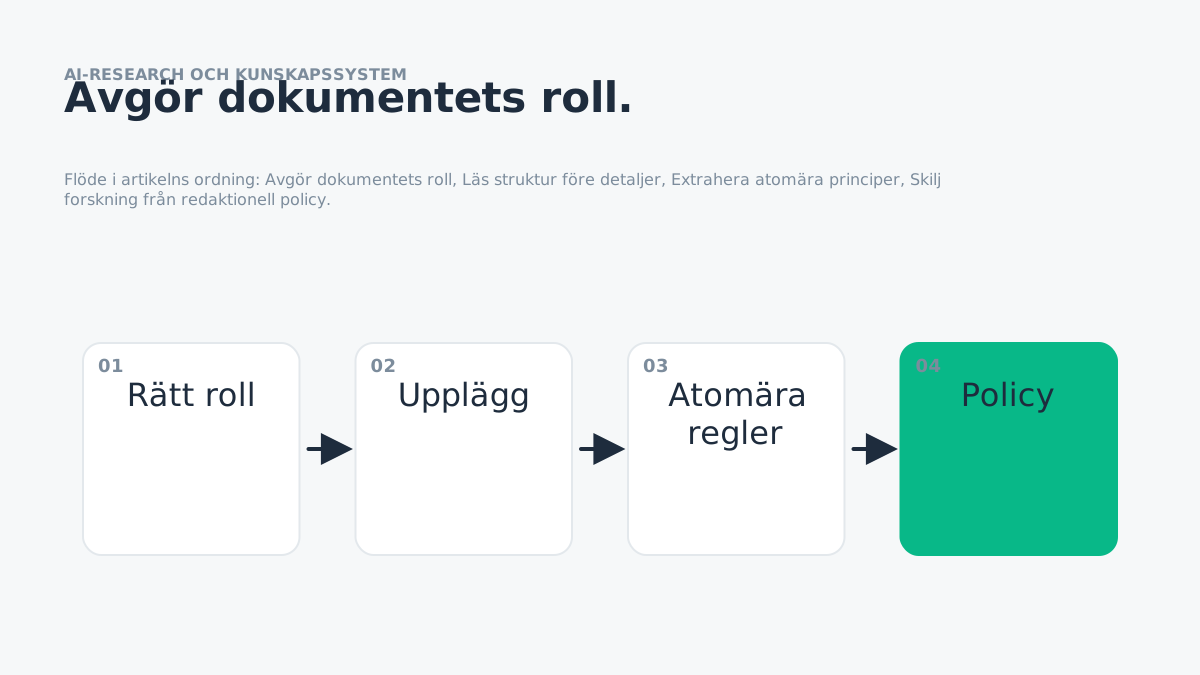
Från PDF till expertagent: ett praktiskt arbetsflöde handlar för mig mindre om en enskild prompt och mer om hur man gör ett återkommande AI-arbete granskningsbart. När jag bygger för egen produktion försöker jag därför göra antaganden, evidens, state och stoppregler synliga. Resultatet blir mindre magiskt, men betydligt lättare att lita på, felsöka och förbättra.
En PDF är input, inte kunskap
Det vanligaste misstaget är att ladda upp en bok eller rapport och säga "bli expert på det här". Modellen kan sammanfatta dokumentet men har då fortfarande inget explicit regelverk för vad som ska gälla i en ny uppgift. Jag behandlar därför PDF:n som råmaterial som först måste konverteras till källor, principer, undantag och testbara beslut.
I praktiken gör jag den här kontrollen som en egen artefakt i stället för som en mental checklista. Det gör att input, beslut och output kan granskas i efterhand: jag vill kunna peka på varför ett steg passerade, vilket underlag som användes och vad som hade fått det att blockeras. Det gör också att samma kontroll kan köras om efter en ändring utan att hela resonemanget behöver uppfinnas på nytt.
Steg 1: avgör dokumentets roll
Är PDF:n normativ, empirisk, pedagogisk eller bara inspiration? En manual kan definiera en procedur. Ett research paper ger avgränsade resultat med metod och begränsningar. En bok kan blanda exempel, hypoteser och personliga modeller. Jag märker dokumenttypen innan extraktionen eftersom samma mening får olika vikt beroende på vilken typ av källa den kommer från.
Kontrollera dokumentets ursprung och begränsningar innan extraktion
Filformatet i sig säger inget om evidensstyrkan — en PDF är ett transportformat, inte en sanningsstämpel. Innan jag extraherar något registrerar jag därför vad dokumentet faktiskt är: primärkälla, policy, marknadsmaterial, utkast eller sekundär sammanfattning, samt titel, författare, datum, version, sidantal och om hela dokumentet faktiskt går att läsa. En saknad appendix eller en gammal version kan förändra slutsatsen.
Ett paper är inte bara abstract och slutsats. Jag vill även fånga metod, urval, negativa fynd och författarnas egna reservationer. Annars blir agenten säkrare i sina påståenden än källan faktiskt är.
Steg 2: läs struktur före detaljer
Jag börjar med innehållsförteckning, sammanfattning, metod, slutsats och centrala rubriker. Målet är en karta över dokumentet så att extraktionen inte blir en samling lösryckta citat. För långa dokument delar jag upp läsningen efter semantiska sektioner men behåller sid- eller avsnittsproveniens.
Steg 3: extrahera atomära principer
Varje användbar regel skrivs som ett eget objekt: regel, källa, scope, trigger, undantag, evidensstyrka och exempel. En generell formulering som "variera meningslängden" är värdelös om paperet egentligen bara visade ett korpusmönster i en specifik genre. Scope måste följa med regeln.
Steg 4: skilj forskning från redaktionell policy
Vissa regler är direkt stödda av dokumentet. Andra är våra egna produktbeslut. Jag märker dem separat och extraherar först vad dokumentet faktiskt säger, innan jag beslutar vilka delar som kan bli operativa regler — det minskar risken att sammanfattningen smyger in egna rekommendationer. Det hindrar oss också från att senare säga "forskningen visar" när vi egentligen menar "det här är en bra redaktionell tumregel". Den distinktionen blev central när jag byggde min Humanizer från forskningsmaterial.
Steg 5: bygg beslutsträd
Expertkunskap blir mer användbar när den kopplas till triggers. Om texttypen är juridisk ska precision väga tyngre än rytm. Om uppgiften kräver first-hand experience men inget sådant underlag finns ska agenten blockera i stället för att skapa en anekdot. Beslutsträd gör det möjligt att återanvända samma kunskap utan att modellen måste återskapa metoden varje gång.
Steg 6: välj rätt bärare
All kunskap ska inte ligga i systemprompten. Kärnregler kan ligga i SKILL.md, detaljerade tabeller och evidens i references, deterministiska kontroller i scripts och stora mallar i assets. Progressive disclosure gör att agenten bara laddar det den behöver. Det är skillnaden mellan ett fungerande expertpaket och en prompt som blir långsammare för varje ny källa.
Steg 7: bygg negativa testfall och testa reglerna före adoption
Jag testar vad expertagenten inte får göra. Kan den applicera en forskningsregel utanför studiens scope? Hittar den på ett citat? Förvandlar den ett korrelationsresultat till kausalitet? Ignorerar den ett undantag när ett exempel ser liknande ut? En ny regel får inte bli produktionsklar bara för att den låter rimlig — jag skapar testfall och kontrollerar att den hjälper i rätt kontext och avstår i fel kontext. Negativa cases avslöjar ofta mer än ett snyggt demonstrationsfall.
Steg 8: versionera kunskapen
När nya papers eller nya utgåvor kommer ska agentens kunskap kunna uppdateras utan att allt skrivs om. Jag behåller source register, rule IDs och changelog. Om en regel ändras kan evals visa vilka outputs som påverkas. Jag dokumenterar också varje sådant beslut i samma korta, läsbara format som jag beskriver i Research layer vs writing layer — varför jag separerar dem: då blir expertagenten ett underhållet kunskapssystem i stället för en engångsprompt.
När PDF→agent är fel lösning
Om användaren bara behöver hitta information i dokumentet räcker retrieval eller vanlig dokumentsökning ofta bättre. Agentisering är motiverad när kunskapen ska styra ett återkommande workflow, när beslut kräver samma expertmetod om och om igen eller när kvaliteten behöver testas mot definierade regler.
Slutsats
Målet med att gå från PDF till expertagent är inte att göra dokumentet kortare. Det är att veta exakt vilken auktoritet varje extraherad regel har och var den slutar gälla — och att kunna bevisa det med en versionerad källa, ett scope och ett testfall, inte bara ett sammanfattat intryck. De generella principerna bakom den typen av granskningsbarhet, och hur jag dokumenterar beslut och avvägningar mellan modell och system, beskriver jag mer utförligt i Research layer vs writing layer — varför jag separerar dem.
Källor och vidare läsning
- Anthropic Agent Skills overview
- Google Search Central helpful content
- NIST — AI Risk Management Framework
Relaterade artiklar
- Så bygger man en Humanizer utan att bara säga 'skriv mer mänskligt'
- Research layer vs writing layer: varför jag separerar dem
- Så auditar jag en Skill innan den används i produktion
- Så extraherar jag regler, principer och undantag ur forskning
- Så skiljer jag på stil, röst, ton och struktur i mina prompts