Så skiljer jag på stil, röst, ton och struktur i mina prompts
"Skriv professionellt men mänskligt, tydligt men engagerande." Den typen av instruktion ser användbar ut men blandar ofta ihop flera olika saker. När resultatet sedan känns fel är det svårt att veta vad som ska ändras.
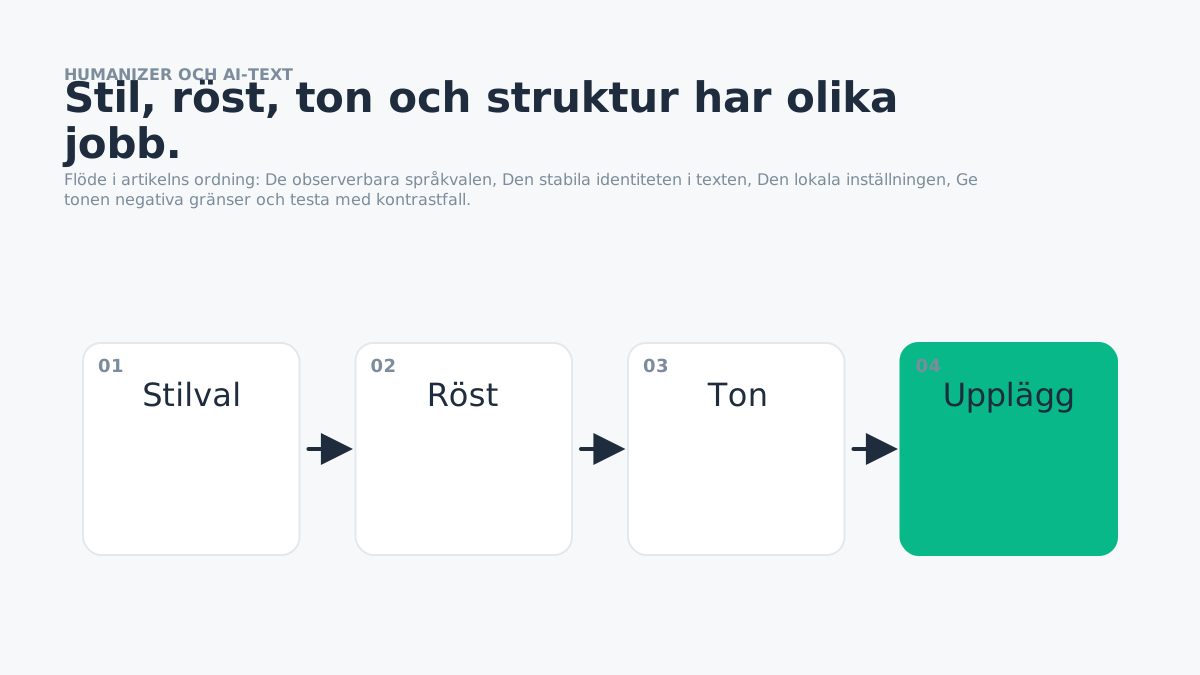
"Skriv professionellt men mänskligt, tydligt men engagerande." Den typen av instruktion ser användbar ut men blandar ofta ihop flera olika saker. När resultatet sedan känns fel är det svårt att veta vad som ska ändras. Var det ordvalet, formaliteten, berättarperspektivet eller hur argumentet var disponerat?
Jag får betydligt bättre kontroll när jag separerar stil, röst, ton och struktur i prompten. De påverkar varandra, men de är inte samma parameter.
Stil: de observerbara språkvalen
Stil är hur texten faktiskt ser ut på språknivå: meningslängd och syntaktisk komplexitet, ordval och terminologisk nivå, mängden metaforer, hur listor och rubriker används, graden av konkretion, formell kontra vardaglig syntax.
En stilinstruktion kan därför vara relativt konkret:
Använd korta till medellånga meningar, svenska facktermer där de behövs och konkreta verb framför abstrakta nominaliseringar. Undvik marknadsföringsspråk.
Det säger mer än "skriv bra" utan att försöka beskriva en personlighet.
Röst: den stabila identiteten i texten
Röst är mer varaktig. Det är den känsla av avsändare som kan finnas kvar även när ämnet och tonen förändras.
I min egen sakprosa vill jag ofta ha en röst som är direkt, tekniskt nyfiken och ganska osentimental. Jag använder första person när det finns ett faktiskt case att hänvisa till, men jag vill inte lägga in personliga anekdoter bara för att skapa närhet.
En användbar röstspecifikation beskriver observerbara drag:
Det är bättre än "skriv som en erfaren AI-expert", eftersom den senare formuleringen lämnar mycket åt modellen att stereotypisera.
Ton: den lokala inställningen
Ton är situationsberoende. Samma röst kan vara lugn i en incidentrapport, kritisk i en audit och mer pedagogisk i en nybörjarguide. Jag ser därför ton som ett lokalt lager ovanpå rösten.
Exempel:
I en annan text kan samma röst ha tonen:
Det gör att jag inte behöver skapa en helt ny "persona" för varje uppgift.
Ge tonen negativa gränser och testa med kontrastfall
Ett tonadjektiv som "varm och professionell" är en bra brief mellan människor men en svag maskininstruktion, eftersom modellen fyller tomrummet med sina vanligaste mönster. Där ett varumärke inte ska låta säljigt räcker "professionell" därför inte ensamt. Jag lägger till negativa gränser: undvik överdrifter, superlativ och vaga värdelöften; börja med problemet; använd konkreta exempel före slogans. Det gör tonen möjlig att utvärdera i stället för att bara låta bra.
Jag testar också ton med kontrastfall: samma fakta skrivs för två målgrupper. Om modellen bara byter några adjektiv har toninstruktionen inte operationaliserats. Om den i stället ändrar informationsordning, terminologi och direkthet utan att ändra fakta är kontrollen mer användbar.
Struktur: ordningen som informationen kommer i
Struktur är det lager som ofta felaktigt behandlas som stil. Om en text har samma sex H2-rubriker varje gång kommer den kännas mallad även om ordvalet är varierat.
Struktur handlar om frågor som: börjar artikeln i ett problem, ett resultat eller ett case? Kommer principen före implementationen eller tvärtom? Behövs en kronologisk build logg eller ett beslutsträd? Ska texten bygga mot ett argument eller fungera som referensguide?
Det är därför jag numera använder olika artikelarketyper i BijoyIQ-fabriken. En post-mortem ska inte ha samma struktur som en technical teardown. En jämförelseartikel ska inte ärva samma "problem → varför standardlösningen brister → metod → felmoder" varje gång.
Varför blandningen skapar dåliga prompts
Om jag skriver:
Skriv varmt, mänskligt, professionellt och varierat med tydlig struktur.
har jag egentligen gett modellen fyra vaga mål utan prioritering. "Varmt" kan påverka tonen, "mänskligt" kan påverka allt och inget, "professionellt" kan trycka stilen mot corporate copy och "varierat" kan få modellen att ändra rytm utan skäl.
Jag föredrar något i den här riktningen:
Anthropic rekommenderar i sin aktuella prompting-guide att komplexa prompts separerar instruktioner, kontext och input tydligt; XML-taggar är ett av deras föreslagna sätt att göra det (guiden uppdateras löpande, så exakt innehåll kan skilja sig från vad som stod där när jag skrev det här). Anthropic prompting best practices.
Lägg inte allt i "tone of voice"
Många brand guides packar in allt i ett enda tone-of-voice-dokument. Problemet är att delar av det egentligen är fakta- och policyregler.
"Säg aldrig att produkten garanterar ett jobb" är inte ton. Det är ett innehållslås. "Skriv du i stället för ni" är stil/tiltal. "Var lugn när användaren har gjort ett misstag" är ton. "Använd inte påhittade kundcase" är en sanningsregel. "Börja varje guide med ett konkret problem" är struktur.
När de här kategorierna separeras blir det också lättare att testa dem. Jag kan kontrollera att en policy följs deterministiskt utan att samtidigt försöka bedöma om texten känns "lagom varm".
En standard för flera skribenter, inte en imitation av en författare
Samma separation gör det möjligt att ge flera skribenter en gemensam redaktionell standard utan att be modellen imitera en namngiven person. Fakta, juridiska formuleringar och tekniska termer är invariants; röst, ton och stil handlar om hur materialet presenteras. Blandas de två kan ett stilpass råka ändra det som egentligen var innehåll.
Ett par godkända texter fungerar då som kalibrering: jag extraherar mönster som "kort intro", "inga överdrivna värdelöften" och "konkret exempel före slutsats" i stället för att be modellen skriva exakt som en viss person. Genren får fortfarande överstyra standarden — juridisk text kan vara mer formell och teknisk dokumentation mer repetitiv — för standardens jobb är konsekvens, inte likformighet. Och jag testar den mot regressionsrisk, inte bara mot om den "låter rätt": om standarden börjar ta bort reservationer, förenkla facktermer för mycket eller göra alla texter lika är den inte bra, oavsett hur enhetlig den ser ut.
Prioritering vid konflikt
Jag skriver också in en prioriteringsordning. Annars kan en toninstruktion kollidera med precision.
För teknisk och faktatung sakprosa använder jag ungefär: sanning och källtrohet, innehållslås, precision och säkerhetsgrad, uppgiftens syfte, röst, ton, stil, variation.
Det betyder att "vänlig ton" aldrig får göra ett osäkert resultat säkert eller ett juridiskt villkor enklare än det faktiskt är.
Röstprov slår adjektiv
Om jag verkligen vill bevara en persons sätt att skriva är ett kort, representativt röstprov ofta bättre än tjugo adjektiv. Men jag ber modellen analysera observerbara drag, inte imitera en mystisk identitet.
Jag kan exempelvis extrahera hur direkt texten är, genomsnittlig meningskomplexitet, hur ofta författaren använder första person, hur tekniska termer introduceras, vilken typ av övergångar som används, och om slutsatser brukar vara öppna eller kategoriska. Sedan översätter jag det till instruktioner som går att granska.
Struktur behöver corpus-QA
Det var också en lärdom från min egen contentfabrik. De första artiklarna kunde vara individuellt okej men blev för lika när de lästes bredvid varandra: ungefär samma rubriktäthet, samma slutsatslogik och samma rytm. Problemet gick inte att lösa genom att "humanisera" varje artikel separat. Det behövde en corpus-nivåkontroll.
Det är ett bra exempel på varför struktur är sin egen dimension. En text kan ha naturliga meningar och ändå kännas maskinproducerad när tjugo artiklar delar samma disposition.
En praktisk promptmodell
När jag bygger en återanvändbar skrivprompt vill jag därför kunna fylla de fyra fälten separat:
Sedan ligger sanningsregler, källkrav och policy utanför de fyra. Det är viktigt: "röst" ska inte bli en säck där hela systemprompten hamnar.
Resultatet blir lättare att felsöka
Den största vinsten är inte att modellen magiskt skriver perfekt. Vinsten är att jag kan säga vad som blev fel.
Om texten låter för säljig justerar jag ton eller stil. Om den inte känns som samma avsändare justerar jag röstlagret. Om alla artiklar ser identiska ut ändrar jag strukturarketyperna. Om fakta glider är det inte något av dessa lager – då har jag ett evidence- eller fidelity-problem.
Det gör prompt engineering mycket mindre mystiskt. Jag arbetar inte med ett moln av adjektiv. Jag arbetar med separata kontroller som går att iterera och testa.
- Anthropic prompting best practices — overview
- StoryScope: Investigating idiosyncrasies in AI fiction