Så gör jag AI-text mindre mekanisk utan att lägga in medvetna fel
Det finns en genväg som ofta dyker upp när någon vill få AI-text att kännas mindre genererad: lägg in stavfel, byt ut ord slumpmässigt, variera meningslängden aggressivt eller skriv lite mer "slarvigt". Jag tycker att det är fel problemformulering.
Det finns en genväg som ofta dyker upp när någon vill få AI-text att kännas mindre genererad: lägg in stavfel, byt ut ord slumpmässigt, variera meningslängden aggressivt eller skriv lite mer "slarvigt". Jag tycker att det är fel problemformulering. Om texten känns mekanisk är målet inte att simulera brister. Målet är att hitta den konkreta redaktionella friktionen och göra minsta ändring som förbättrar den utan att fakta, röst eller säkerhetsgrad förändras.
Det är den viktigaste förändringen i hur jag har byggt min Humanizer. Jag försöker inte längre optimera mot en föreställning om hur "mänsklig text" ser ut. Jag försöker redigera text på samma sätt som en noggrann redaktör: lokalisera det som skaver, förstå varför det skaver och ändra bara det som behöver ändras.
Börja med innehållslås, inte stiltrick
Innan jag ändrar en text låser jag sådant som inte får röra sig: fakta, siffror, datum, namn, citat, länkar, tekniska termer, ståndpunkt och graden av säkerhet i påståendena. Det låter självklart, men det är precis här många "humanizers" blir farliga. En modell som får instruktionen "gör texten mer naturlig" kan utan problem göra ett försiktigt påstående mer kategoriskt, lägga till en anekdot eller byta ett exakt fackbegrepp mot något vardagligare som faktiskt betyder något annat.
Jag vill därför skilja tydligt på tre saker:
- språklig förbättring,
- strukturell redigering,
- innehållsmässig förändring.
De två första kan en Humanizer få göra inom tydliga ramar. Den tredje kräver stöd i källmaterialet eller ett uttryckligt beslut.
Diagnostisera lokalt
Jag använder inte en lista med förbjudna "AI-ord". Jag letar i stället efter observerbara problem i den aktuella texten. Det kan vara att tre stycken börjar på samma sätt, att varje stycke avslutas med en sammanfattande sensmoral eller att texten använder metatext i stället för att ge information.
Ett typiskt exempel är:
Det är viktigt att förstå att AI kan vara ett kraftfullt verktyg. Det är också viktigt att komma ihåg att AI har begränsningar. Genom att förstå både möjligheter och begränsningar kan företag fatta bättre beslut.
Problemet är inte att någon enskild fras "avslöjar AI". Problemet är att stycket säger väldigt lite med tre nästan symmetriska meningar. En bättre redigering är att precisera själva beslutet:
AI är mest användbart när uppgiften kan verifieras. Ju svårare ett fel är att upptäcka eller återställa, desto mer kontroll behöver ligga utanför modellen.
Texten blir mindre mekanisk eftersom den blir mer specifik, inte för att jag lagt till slumpmässighet.
Variation är en bieffekt, inte ett mål
Jag vill inte ha en regel som säger att meningar ska vara 8, 17 och 31 ord långa i någon särskild ordning. Sådana kvoter producerar snabbt en ny sorts mekanik. Samma sak gäller instruktioner om att alltid använda fragment, retoriska frågor eller tankstreck. De kan fungera i en text och vara helt fel i nästa.
Min regel är i stället: ändra rytmen när den faktiska rytmen skapar friktion. Om fem meningar i rad har samma syntaktiska form kan en av dem kortas, två slås ihop eller informationsordningen ändras. Om texten redan flyter finns inget värde i att förändra den för variationens skull.
Det här är också varför jag inte använder "burstiness" eller liknande som ett generativt mål. Ett statistiskt mönster är inte automatiskt ett redaktionellt ideal.
Funktionell variation kommer från innehållets uppgift
När en text faktiskt behöver rytmvariation uppstår den bäst ur informationsfunktionen, inte ur en kvot jag lägger på i efterhand. En kort mening kan markera slutsatsen. Ett längre stycke kan bära ett resonemang. En lista passar när elementen faktiskt är parallella. Formen ska följa uppgiften. Om en juridisk instruktion redan är tydlig med korta, jämna meningar gör jag den inte ojämn för att den ska "se mer mänsklig ut" — där väger genre och precision tyngre än stilvariation, och samma sak gäller teknisk dokumentation.
Ta bort tom inflation före du lägger till något
Den säkraste humaniseringen är ofta subtraktiv. Jag letar efter formuleringar som annonserar betydelse utan att bära information:
- "I dagens snabbt föränderliga digitala landskap ..."
- "Det är värt att notera att ..."
- "Detta understryker vikten av ..."
- "Sammanfattningsvis är det tydligt att ..."
De här formuleringarna är inte förbjudna. Ibland fyller de en funktion. Men när de bara lägger ett lager kommentar ovanpå ett redan tydligt påstående brukar texten bli bättre av att gå direkt på sak.
Det gäller även slutsatser. Om artikeln redan har visat varför ett system behöver evals behöver jag inte avsluta med ett extra stycke som förklarar att "evals därför är viktiga". Jag kan avsluta med den praktiska konsekvensen eller nästa beslut.
Bevara röst i stället för att standardisera den
En annan risk är att "förbättra" all text till samma professionella mellanläge. Då blir resultatet paradoxalt nog mer homogent. Jag försöker därför beskriva den observerbara rösten innan jag redigerar: formalitetsnivå, direkthet, typiska meningslängder, hur mycket första person används, mängden facktermer och hur argumentationen rör sig.
Om författaren skriver kort, rakt och tekniskt ska Humanizern inte lägga till storytelling bara för att göra texten "mänskligare". Om texten är juridisk ska precision väga tyngre än ledig rytm. Om det är en personlig essä kan däremot självkorrigering, asider och längre resonemang vara en naturlig del av rösten.
Det här är ett område där genre måste slå generella stilregler.
Forskning är underlag, inte recept
När jag byggde om Humanizern utifrån forskningsmaterial blev en viktig lärdom att klassificeringssignaler inte automatiskt är kvalitetsregler. StoryScope-studien från 2026 hittar exempelvis narrativa skillnader mellan mänsklig bokfiktion och texter från flera språkmodeller. Bland annat syns skillnader i tematisk explicithet, emotionell gestaltning och narrativ struktur. Men studien gäller en specifik fiktionkorpus och kan inte översättas till regeln "gör svensk sakprosa mer nonlinear".
Det operativa värdet är mer försiktigt: om en fiktiv text redan överförklarar sitt tema kan det vara värt att ta bort redundant förklaring. Det är en redaktionell förbättring i sig. Jag behöver inte hävda att ett visst skiljetecken eller ord är ett universellt AI-tecken.
Primärkälla: StoryScope: Investigating idiosyncrasies in AI fiction.
Min arbetsordning
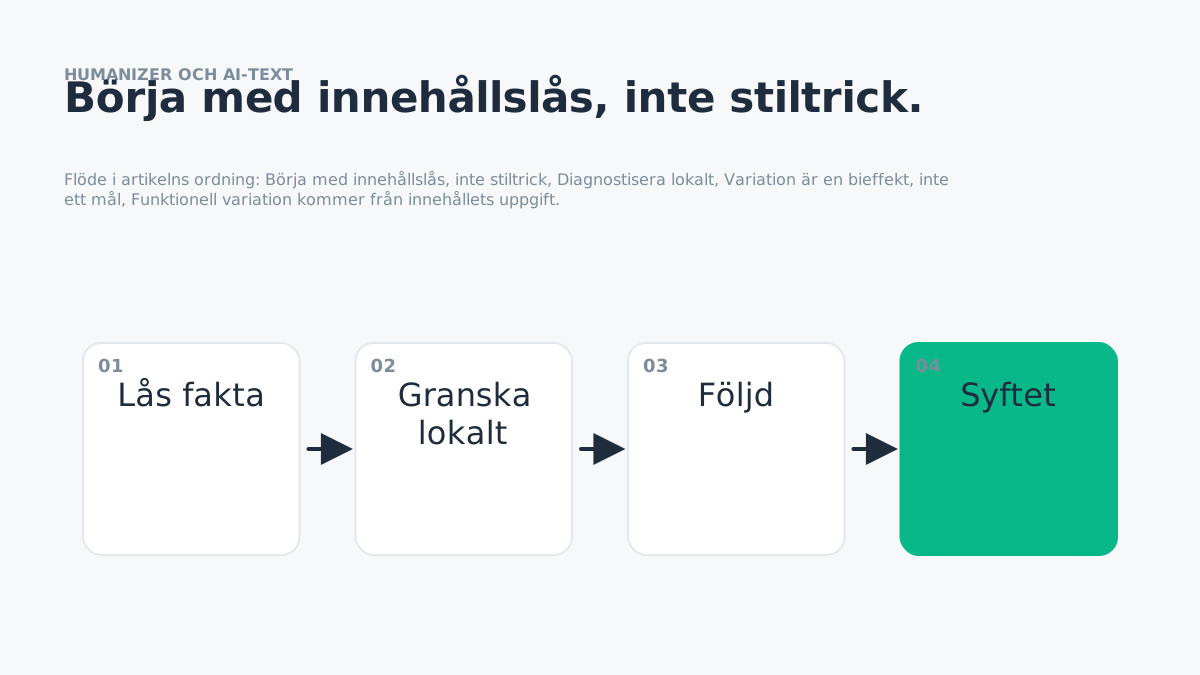
När jag redigerar en AI-assisterad text använder jag i praktiken den här ordningen:
Det viktiga är stoppregeln i slutet: om ytterligare redigering inte ger en tydlig informations-, rytm- eller genrevinst ska jag sluta. En Humanizer som alltid måste förändra text kommer förr eller senare att försämra bra text.
När en fullständig omskrivning faktiskt är motiverad
Redigering och omskrivning är olika operationer, och jag väljer alltid diagnos före åtgärd. Om problemet är två vaga referenter och ett redundant stycke finns ingen anledning att skapa tjugo nya meningar som sedan måste faktakontrolleras igen — det ökar bara ytan för fel utan att lösa det som faktiskt skaver. En större omskrivning är däremot rimlig när informationsordningen är fel, målgruppen har ändrats eller genren kräver en annan struktur. Då behandlar jag det som en developmental edit och inte som en kosmetisk humaniseringspass, men innehållslåset gäller precis lika strikt genom hela processen.
Vad jag uttryckligen inte gör
Jag lägger inte in avsiktliga stavfel. Jag hittar inte på personliga minnen. Jag skapar inte falska citat eller källor. Jag slumpar inte synonymer. Jag tvingar inte fram slang. Jag lägger inte till flashbacks, moraliskt tvivel eller humor bara för att sådant kan förekomma oftare i mänskliga texter.
Och jag lovar inte att texten blir "odetekterbar". AI-detektorer är ett annat problem än textkvalitet. En redigering ska kunna motiveras utan att säga "detta lurar en detektor".
Den bättre frågan
Jag tycker därför att frågan "hur gör jag AI-text mer mänsklig?" är lite för grov. Den bättre frågan är:
Vad i just den här texten skapar friktion för den här läsaren, och vilken är den minsta ändringen som förbättrar det utan att ändra innehållet?
När jag bygger Humanizer-regler från den frågan får jag ett verktyg som fungerar även när modellerna förändras. Det är mer hållbart än att jaga nästa lista med ord, skiljetecken eller ytmönster som råkar vara vanliga i dagens modellgeneration.