Hur jag hanterar regler, belopp och datum i AI-genererade artiklar
Regler, belopp och datum är de claims jag litar minst på över tid. De kan vara fullständigt korrekta när artikeln skrivs och fel sex månader senare. Därför behandlar jag dem inte som vanliga faktapåståenden. De får en egen freshness-klass och ett tydligt verifieringsdatum.
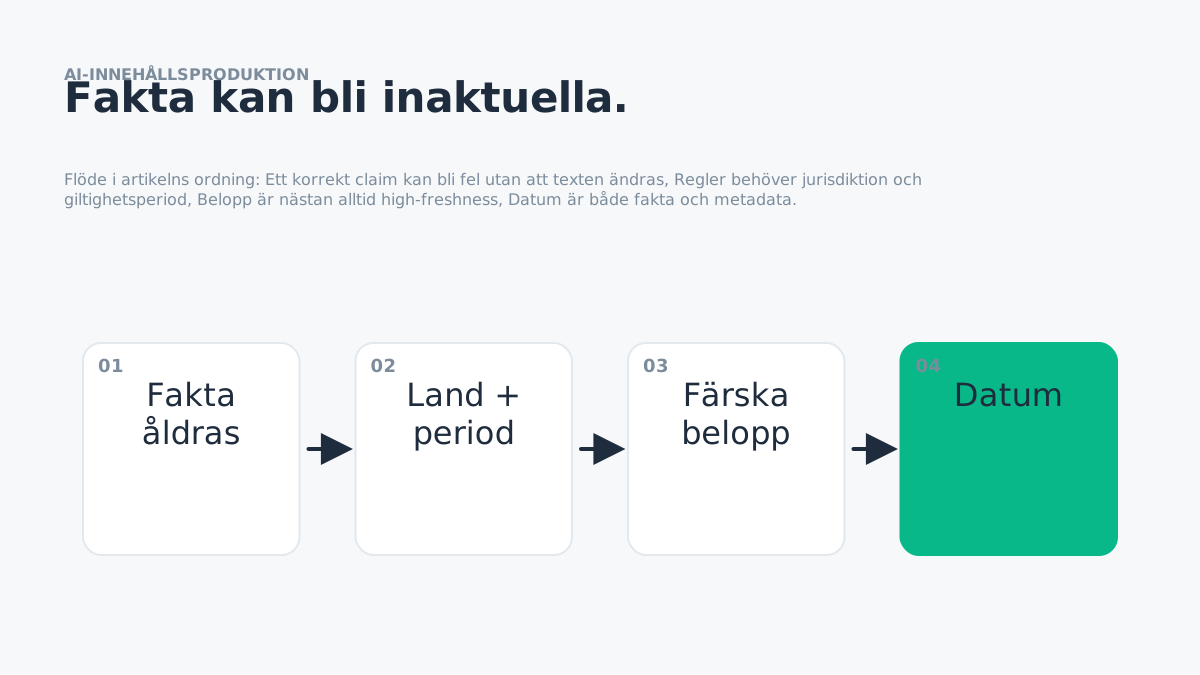
Regler, belopp och datum är de claims jag litar minst på över tid. De kan vara fullständigt korrekta när artikeln skrivs och fel sex månader senare. Därför behandlar jag dem inte som vanliga faktapåståenden. De får en egen freshness-klass och ett tydligt verifieringsdatum.
Ett korrekt claim kan bli fel utan att texten ändras
Det här är den viktigaste skillnaden mellan tidlösa och tidskänsliga fakta. Ett historiskt årtal kan ofta verifieras en gång, medan ett pris, inkomstkrav, API-beteende eller myndighetsregel kan kräva återkommande kontroll.
Jag sparar därför mer än source_url:
Det gör att systemet kan förstå att två claims med samma källa ändå kan behöva olika behandling.
Regler behöver jurisdiktion och giltighetsperiod
En vanlig AI-risk är att en regel återges utan villkor. För myndighetsnära information vill jag därför veta vilket regelverk, vilken målgrupp och vilket datum claimen avser. Om en regel ändras behöver jag kunna hitta exakt vilka artiklar som är beroende av den.
I stället för att lagra "kravet är X" vill jag kunna lagra "kravet är X för kategori Y från datum Z enligt källa S". Det är mer omständligt, men betydligt säkrare.
Belopp är nästan alltid high-freshness
Priser, gränsvärden, avgifter och ekonomiska krav får normalt hög freshness-risk. Jag vill inte att en Writer återanvänder ett gammalt belopp bara för att det finns i en tidigare publicerad artikel.
Därför får sådana claims en policy som kräver recheck före publicering när verifieringen är äldre än den definierade toleransen. Toleransen kan skilja sig mellan ämnen; poängen är att den är explicit.
Datum är både fakta och metadata
Datum kan vara själva påståendet, men också berätta när påståendet var sant. Jag separerar därför publiceringsdatum från verified_at, effective_from och source_updated_at.
Det gör det möjligt att skriva "kontrollerat 2 september 2026" utan att låtsas att artikeln kommer vara korrekt för alltid.
Freshness ska trigga beroendeanalys
När en källa ändras vill jag inte bara flagga källan. Jag vill traversera beroenden:
Det är här content maintenance börjar likna vanlig software maintenance.
Modellen får inte gissa nästa värde
Om en källa inte längre går att verifiera ska claimen inte uppdateras genom extrapolering. UNRESOLVED eller BLOCKED är bättre än ett sannolikt men osourcat belopp.
Google betonar att content ska vara korrekt, pålitligt och skapat för människor. För mig betyder det att freshness måste vara en del av produktionssystemet, inte en manuell årlig städning.
Min minsta freshness-policy
Jag vill åtminstone kunna svara på tre frågor för varje tidskänsligt claim: När verifierades det? Mot vilken primärkälla? När måste det kontrolleras igen?
När de tre fälten finns kan automation hjälpa till. När de saknas har man bara en gammal artikel och ett hopp om att världen inte har förändrats.