Så håller jag en Skill uppdaterad när forskningen förändras
En Skill som byggs från forskning blir gammal på två olika sätt. Källorna kan förändras, men även produkten eller modellen som ska använda reglerna kan förändras.
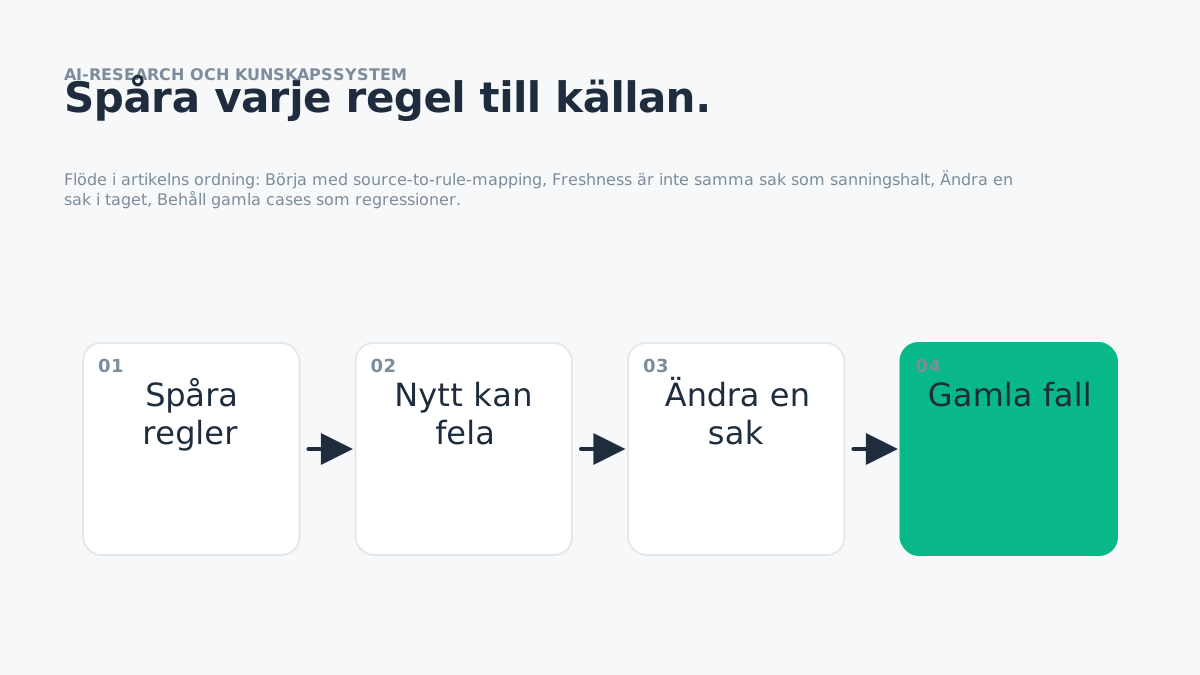
En Skill som byggs från forskning blir gammal på två olika sätt. Källorna kan förändras, men även produkten eller modellen som ska använda reglerna kan förändras. Jag försöker därför behandla uppdatering som en kontrollerad migration: först identifiera vilka claims som påverkats, sedan ändra regeln, därefter köra samma evals som tidigare. Att bara läsa om SKILL.md och skriva om den är för grovt; jag vill veta exakt vilken del av beteendet som måste ändras och vad som ska förbli stabilt.
Börja med source-to-rule-mapping
Varje forskningsgrundad regel behöver en källa och en deklarerad räckvidd. När en källa uppdateras kan jag då hitta vilka regler som faktiskt beror på den i stället för att anta att hela Skillen måste skrivas om. Det gör kontrollen granskningsbar: jag vill kunna peka på vilken artefakt som bar beslutet och vad som skulle behöva ändras för att samma case ska få ett annat utfall.
Freshness är inte samma sak som sanningshalt
En äldre studie kan fortfarande vara relevant, medan produktdokumentation kan bli inaktuell på månader. Jag sätter därför olika recheck-cadence för forskning, API-beteenden och redaktionella policies. Jag testar alltid minst ett fall där principen borde stoppa flödet: om modellen ändå producerar ett självsäkert resultat har jag byggt en rekommendation, inte en gate.
Ändra en sak i taget
Jag separerar source update, regeländring och evaländring. Om alla tre byts samtidigt går det inte att veta varför beteendet förbättrades eller försämrades. I skala blir det här också ett datahanteringsproblem: när IDs, status och ägarskap är explicita går det att återöppna just de delar som påverkas av en ny källa eller en regression.
Behåll gamla cases som regressioner
Tidigare fel och borderline-fall ligger kvar även när forskningen utvecklas. En ny regel får inte lösa dagens problem genom att återintroducera gårdagens. Det är viktigt att scope följer med: en regel som fungerar i ett visst innehåll eller en viss riskklass ska inte automatiskt bli global standard för alla agentuppgifter.
Kvalificera i stället för att överstyra
Ny evidens behöver inte alltid ersätta gammal. Om resultat gäller olika genre eller population kan rätt uppdatering vara att lägga till scope och routing, inte att krona en universell vinnare. Jag försöker hålla nästa steg enkelt: handoffen ska innehålla evidens, beslut, osäkerhet och nästa ägare i stället för att nästa agent behöver tolka hela historiken.
Versionera limitations
När evidensläget ändras uppdaterar jag inte bara själva regeln utan också vad Skillen uttryckligen inte får hävda. Det hindrar en ny källa från att få större räckvidd än den förtjänar. Det här är en av de punkter där bättre struktur ofta slår en dyrare modell: om systemet inte vet vad som ska mätas kommer mer reasoning bara ge ett mer övertygande oklart svar.
Kör om trigger-test
En uppdaterad Skill kan få annan terminologi och därmed trigga på fel uppgifter. Description och examples behöver därför regressionstestas tillsammans med innehållet. En bra regression här är medvetet tråkig: samma case ska kunna köras efter en promptändring, modelluppgradering eller refaktorering och visa exakt vilken dimension som flyttade sig.
Release först när diffen är begriplig
Jag vill kunna skriva ett beteendediff: vilken regel ändrades, vilken källa motiverar det, vilka evals passerade och vilka kända osäkerheter finns kvar. Jag behandlar därför misslyckanden som framtida testdata: ett dyrt fel som bara dokumenteras i en post-mortem är en missad möjlighet, nästa release bör möta samma situation i evalsviten.
Ett kontrakt som går att testa
Jag kondenserar det till ett litet testbart kontrakt av samma slag som jag beskriver i så tänker jag kring evals innan lansering — poängen är att systemet kan byta modell eller implementation utan att samtidigt byta definitionen av vad som är bra.
Slutsats
En forskningsdriven Skill ska kunna förändras utan att historien skrivs om. Source-to-rule mapping, versionerade limitations och stabila regressioner gör att ny evidens kan förbättra beteendet utan att varje uppdatering blir en total omskrivning.