Så bygger jag ett AI-workflow i n8n från början
n8n är lätt att börja med och därför lätt att bygga fel i. Man drar in en trigger, kopplar en modell, lägger till Slack eller Google Sheets och har ett demo-workflow på en halvtimme.
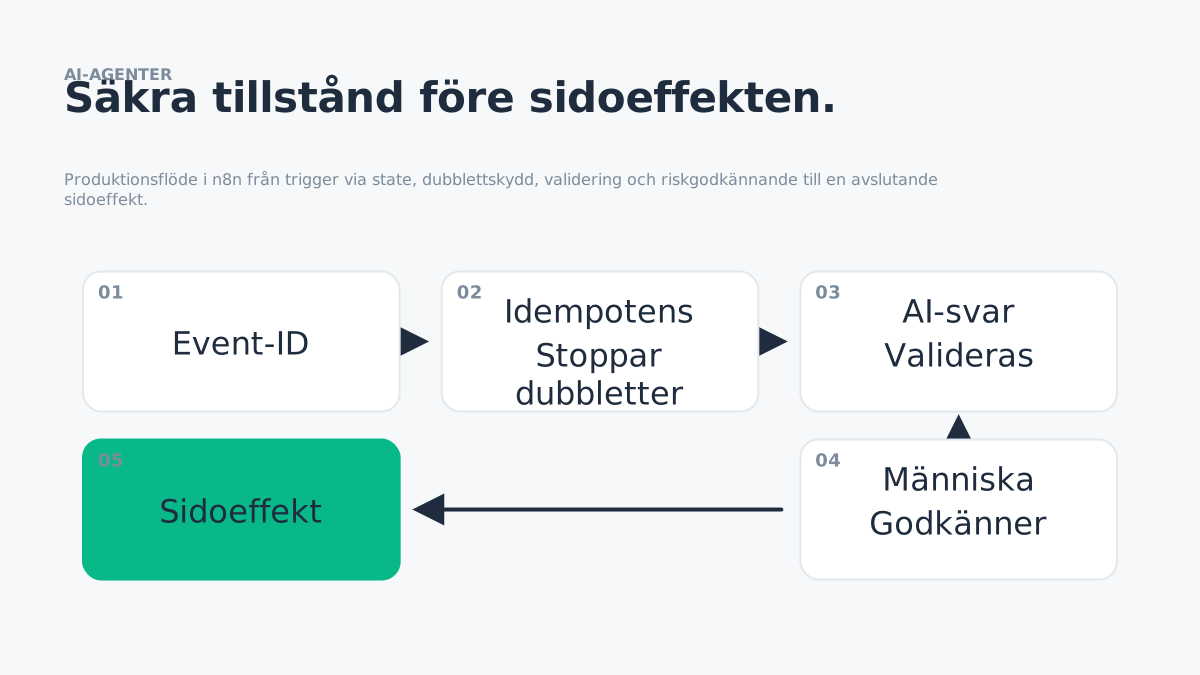
n8n är lätt att börja med och därför lätt att bygga fel i. Man drar in en trigger, kopplar en modell, lägger till Slack eller Google Sheets och har ett demo-workflow på en halvtimme. Problemet märks först när flödet ska köras varje dag, hantera hundratals objekt, överleva ett API-fel och inte göra samma sak två gånger. Jag använder n8n för flera AI-flöden och kör det self-hosted med Postgres och worker. Min viktigaste lärdom är att ett hållbart AI-workflow inte börjar med AI Agent-noden. Det börjar med state, idempotens, felhantering och en tydlig definition av vad som får hända automatiskt.
Börja med händelsen som ska driva flödet
Jag försöker definiera triggern utan AI först. Vad är det som faktiskt har hänt? Det kan vara:
- en webhook tog emot en order,
- ett schema startade dagens batch,
- en ny fil lades i en mapp,
- en recension hämtades,
- ett content-item gick från
[research](/blogg/fa-ai-att-lasa-ett-dokument-cover-to-cover)tillevidence-ready, - en tidigare execution misslyckades och ska återupptas.
Sedan ger jag händelsen ett stabilt ID. Det är första byggstenen för idempotens.
Exakt format varierar, men principen är att samma externa händelse ska kunna kännas igen om den kommer två gånger.
Den klassiska missen: AI-noden i mitten och inga states
Ett dåligt första flöde ser ofta ut så här:
Det fungerar tills något av följande händer:
- modellen returnerar trasigt format,
- API:t på slutet ger 500,
- execution retryas,
- samma webhook skickas igen,
- modellen producerar något som kräver mänsklig kontroll,
- den externa tjänsten accepterar requesten men n8n hinner inte registrera success.
Då vet systemet inte vad som redan hände. Jag föredrar:
Det är fler noder. Det är också ett system man kan felsöka.
Idempotens före retry
n8n har execution-historik och stöd för att retrya misslyckade workflows. Det är användbart, men retry utan idempotens kan vara farligt. Anta att ett workflow genererar ett kundsvar och sedan skickar mejlet. Mejlet skickas, men nästa nod som skulle markera databasen som sent misslyckas. Om hela executionen körs om kan samma mejl skickas igen. Därför vill jag helst registrera side effects med en idempotency key eller kontrollera målstatus före skrivning.
Om mål-API:t stöder idempotency keys använder jag dem. Om inte behöver jag skapa motsvarande kontroll själv.
Separera compute från commit
Research, analys och draft kan i regel köras om fritt — det kostar tid och ibland pengar, men skapar ingen extern konsekvens. Externa side effects vill jag däremot samla i ett tydligt commit-steg med hårdare kontroller: skicka mejlet, publicera artikeln, skapa ordern. Den uppdelningen gör det enkelt att avgöra vad som får retryas fritt och vad som kräver en idempotency-kontroll först.
Alla system stöder inte perfekt idempotens i sig. Då vill jag ha en explicit compensating action, alltså en rollback- eller reconcile-process som kan hitta och rätta dubbla effekter i efterhand, i stället för att låtsas att problemet inte finns.
AI-output ska behandlas som opålitlig input
En annan regel: bara för att modellen ligger mitt i mitt eget workflow betyder det inte att outputen är betrodd. Jag validerar den på samma sätt som data från ett externt API. Om jag förväntar mig:
vill jag inte låta nästa nod tolka fri prosa. Jag använder strukturerat output när modellen stöder det eller validerar JSON/schema efteråt. Saknas fält går flödet till review eller error path. Det är särskilt viktigt om AI-output senare styr ett verktyg.
Human approval ska ligga precis före risksteget
n8n dokumenterade, vid den här artikelns publicering, stöd för human-in-the-loop kring AI tool calls — det är värt att stämma av mot aktuell n8n-version innan man bygger vidare på det. Jag gillar principen även när jag inte använder exakt den funktionen. Människan ska inte godkänna "AI:n har tänkt". Hon ska godkänna den konkreta handlingen som har konsekvens. Exempel:
För content kan motsvarande vara att research och utkast sker automatiskt, medan publicering kräver Publisher Gate. För ekonomiska eller kundpåverkande handlingar kan tröskeln vara hårdare. Det minskar confirmation fatigue. Om varje nod kräver ett klick har man inte byggt automation.
Error workflow är en del av huvudarkitekturen
Jag betraktar inte felhantering som ett tillägg efter att flödet fungerar. Redan när jag ritar huvudflödet bestämmer jag vad som ska hända vid:
- transient API error,
- rate limit,
- invalid model output,
- missing source data,
- auth failure,
- permanent business-rule rejection,
- okänd exception.
Alla fel ska inte retryas. Ett 429 eller tillfälligt 503 kan vara retrybart. Ett saknat obligatoriskt kund-ID blir inte bättre av fem nya försök. Jag klassificerar därför fel ungefär:
n8n:s execution-vy gör det möjligt att filtrera failed/running/success/waiting och retrya tidigare executioner. Det är bra operativt stöd, men klassificeringen måste fortfarande finnas i workflowdesignen.
Dead-letter är ofta enklare än smart självläkning
När ett objekt inte går att processa efter rimliga försök lägger jag det hellre i en tydlig "needs attention"-kö än låter agenten improvisera en lösning. Det kan vara en databasrad, ett separat workflow, en Slack-notis eller en tabell med:
Det viktiga är att objektet inte försvinner. AI-workflows har fler mjuka fel än klassisk automation. En execution kan tekniskt vara "success" samtidigt som outputen är dålig. Därför behöver dead-letter-logiken även kunna triggas av kvalitetsvalidering, inte bara exception.
Batch processing: separera throughput från concurrency
Jag har mål där många objekt ska processas, exempelvis content eller mediaproduktion. Det är lockande att bara öka concurrency. Men API-limits, modellkostnad, DB-lås och downstream-system gör att mer parallellitet inte alltid är snabbare. Jag föredrar kontrollerade batcher:
Det sista är viktigt. Om fem artiklar researchas ska inte alla automatiskt gå vidare till draft. Bara de som passerar evidence audit ska göra det. Det är samma pipeline-batching jag använder i contentfabriken: researcha batchen, kontrollera batchen, avancera den godkända delmängden.
Jag sparar också en hash av inputen till varje objekt. Har samma objekt redan processats med samma version behöver det inte köras igen — det sparar både pengar och felsökningstid, och gör att ett enskilt objekt kan gå till FAILED eller REVIEW_REQUIRED utan att stoppa resten av batchen.
Queue mode när execution-mängden växer
Vid den här artikelns publicering är queue mode relevant för self-hosted n8n när man vill skala execution-arbete över workers — precis som med human-in-the-loop-funktionen bör rekommendationen stämmas av mot aktuell n8n-version. Jag kör själv Postgres + worker-setup, och den arkitekturen gör en mental skillnad även innan belastningen är enorm: web/processen som tar emot och organiserar arbete behöver inte vara samma process som utför allt. Men queue mode löser inte dåligt workflow-state. Fler workers kan tvärtom exponera race conditions snabbare. Om två workers kan plocka samma logiska objekt måste claim/lock/dedupe vara robust. Jag vill alltså lösa unique event identity, claim semantics och idempotenta side effects. Först därefter är concurrency ett problem värt att optimera.
Jag sparar det som behövs för att reproducera beslutet
Observability för AI behöver lite mer än "execution succeeded". Jag vill kunna se:
- workflow-version,
- source object/event ID,
- modell eller route,
- prompt/spec-version,
- relevant source reference,
- strukturerad output,
- valideringsresultat,
- side effect,
- kostnad/latens där det är relevant.
Det betyder inte att jag loggar all känslig promptdata i klartext. Tvärtom måste secrets och persondata hanteras medvetet. Men jag vill ha tillräckligt med provenance för att förstå varför ett beslut togs.
Workflow-versionering är viktigare än promptversionering
När något går fel frågar man ofta "vilken prompt användes?". Jag vill även veta vilken nodlogik, vilka mappingar och vilka transformationsregler som gällde. Ett AI-workflow är summan av:
Därför behandlar jag workflowdefinitionen som kodliknande artefakt. Export, versionshistorik och tydliga changes är mer värdefullt än att bara spara prompts i ett dokument.
Ett konkret exempel: automatiserade reviewsvar
Ta ett enklare workflow för att svara på kundrecensioner. Ett naivt flöde kan låta AI skriva och posta direkt. Jag skulle hellre göra:
Klassificeringssteget separerar policyn — betyg, ämne, kritik, beröm och eventuell eskaleringsrisk — från själva formuleringen. Variation ska dessutom komma från innehåll och situation, inte slumpmässig synonymisering. Annars får man 30 "unika" svar som fortfarande känns som samma robot.
Negativa recensioner får hårdare guardrails än positiva. Modellen ska inte argumentera, avslöja kunddata eller erkänna ansvar för något den inte kan verifiera — den typen av svar ska gå till mänsklig review i stället för att postas automatiskt.
Ett konkret exempel: AI till Google Docs
Google Docs är ett bra slutsteg i ett AI-flöde när människor fortfarande ska läsa, kommentera och redigera resultatet. Jag försöker dock hålla dokumentet som presentation, inte som source-of-truth. Ett enkelt upplägg är:
I n8n eller kod kan Docs API skapa dokumentet och batchUpdate fylla det med strukturerat innehåll. Jag sparar document-ID:t i workflow-state, så flödet slipper skapa en ny kopia varje gång och i stället kan uppdatera rätt dokument idempotent.
Precis som med review-svaren skriver jag inte direkt till dokumentet före QA. AI-output ska passera schema- och faktakontroller innan den når den mänskliga arbetsytan — annars blir Docs snabbt ett arkiv för halvfärdiga outputs.
Ett konkret exempel: content pipeline
Min större contentmotor använder samma principer men fler states:
Varje transition har ett kontrakt. draft betyder inte "en textfil finns". Det betyder att evidence-ready och outline redan passerat sina krav. ready betyder inte "nästan klar"; inga obligatoriska release-actions får återstå. Det är sådana state-definitioner som gör att n8n eller en annan orchestrator kan styra arbetet utan att förstå all semantik själv.
När jag använder en AI Agent-node och när jag inte gör det
Jag använder agentbeteende när modellen faktiskt behöver välja mellan verktyg eller planera dynamiskt. Om flödet däremot alltid är:
behöver jag ofta ingen agent. Ett vanligt model call är enklare, billigare och lättare att testa. Samma sak med deterministiska beslut. Om rating <= 2 alltid ska gå till human review behöver jag inte fråga modellen. En regel jag gillar är:
Ge modellen frihet bara där variationen i problemet kräver frihet.
Resten kan vara vanliga n8n-noder.
Min produktionschecklista
Innan jag aktiverar ett AI-workflow frågar jag:
- Finns stable event ID?
- Kan samma event köras två gånger utan dubbel side effect?
- Är varje externt write-steg tydligt markerat?
- Är AI-output schema-validerat?
- Finns separata paths för transient och permanent error?
- Kan ett objekt hamna i dead-letter i stället för att försvinna?
- Är secrets och credentials korrekt avgränsade?
- Finns human approval där konsekvensen kräver det?
- Kan jag rekonstruera vad som hände från execution/logg?
- Vet jag vad som händer om modellen eller downstream-API:t är nere?
Om svaret är nej på flera av dem är workflowet fortfarande en demo.
Det som gör n8n bra för AI är inte AI-delen
Det låter motsägelsefullt, men det jag uppskattar mest är att n8n gör modellen till en komponent bland andra. En LLM-call kan ligga mellan databas, IF-node, validator, webhook och human approval. Det tvingar fram en nyttig fråga: vad behöver egentligen vara probabilistiskt? När jag började bygga mer agentiska system trodde jag att mer autonomi skulle ge mer automation. I praktiken har jag fått bäst resultat genom att göra states och side effects mer deterministiska och låta AI:n vara flexibel bara inne i avgränsade steg.
Det är den skillnaden som tar ett n8n-flöde från en snygg canvas till något jag kan låta köra varje dag utan att bevaka varje execution manuellt.
Jag delar upp stora workflows i sub-workflows
När ett n8n-canvas börjar få femtio noder blir det svårt att förstå state och svårt att återanvända logik. Jag bryter därför gärna ut stabila delar som egna sub-workflows. Exempel:
eller:
Sub-workflowet får ett tydligt input/output-contract. Då kan jag testa normalize-review separat och byta modell i generate-response utan att röra resten. Det ligger nära hur jag bygger agentkedjor i Claude Code: ansvarsfördelning är viktigare än att allt tekniskt körs av olika "agenter".
Databasstate slår canvas-minne
För workflows som kan pågå länge vill jag inte att enda sanningen är n8n:s execution state. Jag sparar business state i Postgres eller annan persistent store.
Då kan en ny execution fortsätta där den gamla slutade. Det blir också lättare att migrera workflowet eller köra delar utanför n8n senare. Detta är särskilt användbart när AI-jobb väntar på human approval. Objektet kan stå i awaiting_review i databasen i stället för att hela logiken blir beroende av en mycket lång levande execution.
Jag skiljer tekniskt success från business success
En execution kan vara grön i n8n men ändå ha producerat en dålig artikel, ett tomt svar eller en klassificering som inte gick att använda. Därför vill jag ha ett business verdict efter viktiga steg:
eller:
Det gör observability mycket bättre. Dashboarden behöver inte bara visa "98 % executions succeeded". Den kan visa hur många objekt som faktiskt nådde godkänt slutstate.
Rate limits ska designas in från början
När flera AI-kanaler delar API-budget kan spikes skapa 429 även om varje workflow ser rimligt ut isolerat. Jag vill därför ha concurrency controls eller central kölogik kring dyra providers. En enkel policy kan vara:
Jag vill också kunna prioritera. Ett användarinteraktivt CV-svar kan vara viktigare än nattens batch med 100 social assets. Det blir ett argument för att hålla task metadata tillsammans med jobbet:
Cost guardrails hör hemma i workflowet
AI-automation kan misslyckas ekonomiskt utan att något tekniskt är trasigt. En loop kan skicka samma långa context tio gånger och fortfarande returnera success. Jag vill därför logga ungefärlig token-/providerkostnad per jobb och sätta budgettak för särskilda flöden.
För batchar kan jag dessutom sätta daglig budget. Det är enklare att bygga innan första kostnadsspiken än efter.
Räkna kostnad per godkänd asset, inte per generation
När jag ska uppskatta kostnaden för till exempel 100 AI-genererade assets per dag räknar jag inte bara 100 × modellpris. Ett produktionsflöde innehåller research, retries, bild/video, lagring och ibland mänsklig review, så jag bryter ned kostnaden per kategori:
Sedan räknar jag ett låg-, bas- och högscenario. Retry-rate är ofta en dold kostnad: om 15 procent av jobben behöver ett andra försök ska det ligga i modellen från början, och samma sak gäller genereringar som kasseras av QA. Det relevanta måttet är därför sällan kostnad per generation, utan kostnad per godkänd och publicerad asset.
Credentials och node permissions behöver en modell
n8n:s workflow sharing visar en intressant detalj: credentials och workflow access är separata frågor, och least privilege påverkar vad editors kan ändra. I mina egna self-hosted flöden vill jag tänka likadant även när jag är enda operatören. Ett AI-steg som bara behöver läsa Google Sheets ska inte automatiskt få en credential som kan skriva eller radera där det går att undvika. En agenttool som bara behöver skapa draft ska inte ha publish-tool i sin toolset. Det är samma blast-radius-tänk som i A003, men n8n gör det konkret på nodnivå.
Jag testar failure paths medvetet
Happy path är lätt. Före produktion försöker jag framkalla fel:
- returnera invalid JSON från AI-step,
- simulera 429,
- stäng av credential,
- skicka duplicate webhook,
- gör downstream API långsamt,
- låt DB write misslyckas efter external side effect,
- skicka item som saknar obligatoriskt fält.
Sedan frågar jag: blir objektet dubbelt, försvinner det, fastnar det, eller blir state begripligt? Det är min motsvarighet till chaos testing på liten skala.
Webhooks behöver autentisering och replay-tänk
Ett offentligt webhook-endpoint är en attackyta. Jag vill verifiera signatur/token där källsystemet stödjer det och separera raw payload från normaliserad data. Jag vill också kunna hantera replay. Samma legitima webhook kan komma två gånger. Därför är authentication inte ersättning för idempotens.
Båda behövs.
En webhook bevisar bara att eventet kom fram — den säger inget om att det blev klart hanterat. Därför separerar jag helst mottagande från processing: tar emot, validerar och köar tungt arbete som research, filbearbetning eller flera modellsteg, i stället för att låta webhooksvaret vänta på hela AI-kedjan.
Ett workflow ska kunna förklara varför det stannade
I min contentfabrik använder jag blocker-states i stället för generiskt error. Jag vill föra samma idé till n8n:
Det gör nästa steg maskinläsbart. FAILED_PROVIDER kan retryas. BLOCKED_MISSING_SOURCE ska tillbaka till research. BLOCKED_HUMAN_APPROVAL ska vänta. Om allt bara blir "Error" tvingas operatören läsa loggar för varje item.
När jag skulle flytta logik ut ur n8n
Jag tycker n8n är starkt som orchestrator, men jag försöker inte pressa in all affärslogik i Code nodes. När logik blir:
- komplex och testintensiv,
- återanvänd mellan många workflows,
- performancekritisk,
- bättre uttryckt som ett service/API,
flyttar jag den hellre till kod och låter n8n orkestrera anropet. På så sätt undviker jag en gigantisk visuell monolit som i praktiken är ett backend-system utan vanliga tester.
Min minimala referensarkitektur
Om jag skulle ge någon en bas att kopiera skulle den se ut så här:
Det är inte det minsta workflowet i antal noder. Men det är den minsta arkitektur jag tycker börjar bete sig som produktion.
Min regel för återkörning av en hel batch
När en provider eller datakälla varit nere vill jag inte trycka "retry all" blint. Först grupperar jag misslyckandena efter failure class och frågar vilka side effects som redan kan ha skett. Därefter återkör jag bara objekt som har en verifierbar idempotensväg. För ett medieflöde kan ett objekt exempelvis redan ha renderats hos en extern tjänst trots timeout i n8n. Då bör retry-steget först fråga providern efter befintligt jobb-ID innan ett nytt renderjobb skapas. För content kan research vara sparad men statusuppdateringen ha fallerat; då ska workflowet återuppta från nästa state, inte göra om research och skapa nya källversioner.
Den här typen av resume-semantik är tråkig att bygga, men den är skillnaden mellan automation som sparar tid och automation som producerar dubbletter när något går fel.
När ett enkelt script är bättre än n8n
Jag använder inte n8n av princip. En liten deterministisk transform som läser en fil, validerar JSON och skriver en annan fil kan vara bättre som testbart Python- eller Node-script. n8n får då orkestrera scriptet och hantera integrationsdelarna. Det ger en bra gräns: workflowet visar affärsflödet; koden äger komplex, återanvändbar logik. När jag märker att en Code node växer till flera hundra rader eller behöver egna testfixtures är det ofta dags att flytta ut den.
Vad jag skulle mäta efter första månaden
När workflowet väl går stabilt vill jag inte bara följa uptime. Jag vill se hur stor andel objekt som kräver retry, hur många hamnar i human review, median och p95-latency, kostnad per accepterat output och vilka failure classes som dominerar. Om 30 procent av allt går till manuell review har jag sannolikt inte automatiserat rätt del av jobbet. Om nästan inget går till review kan det lika gärna betyda att gaten är för svag. De måtten hjälper mig välja nästa förbättring. Färre noder eller snabbare modell är inte alltid rätt svar; ofta är en bättre validator eller tydligare input contract mer värdefullt.
- Google Docs API
- Google Business Profile API — Reviews
- n8n Docs — Error handling
- OpenAI — API pricing
- n8n Docs — Webhook-nod
Relaterade artiklar
- Så använder jag Claude Code för att skriva SQL mot riktiga produktionsdata
- Så sätter jag guardrails runt AI utan att döda användarupplevelsen
- Min Research → SEO → Compliance → Brand → Writer-pipeline
- Så bygger jag fallback när modellen eller API:t ligger nere
- Så dokumenterar jag tabeller och business rules så AI förstår dem